


Google Cloud が提言、AI エージェントから本番 DB を守る「サービング DB」と3つの設計要件
公開:
AI エージェントは、データベースの設計者が想定した通りにはアクセスしてこない。業務の本番データを AI エージェントに使わせるとき、データベースはどう備えればよいのか。
Google Cloud の「Data & AI Summit '26 Fall」で、Google Cloud の大久保 順氏が、AI エージェント特有のデータベースへのアクセスパターンと、その対策を解説した。既存システムには本番 DB の手前に「サービング DB」を置いて負荷を分ける構成を、新規システムにはスケールするデータベース、MCP によるアクセス制御、コンテキストを与える層の3つを、設計要件として提案した。
この記事の要点
- AI エージェントは、高速な試行錯誤、予測できない並列度、インデックスの効かない重いクエリで、人間の定型操作を前提に作られた本番の OLTP データベースを圧迫しうる
- 既存システムには、本番 DB から CDC で変更差分を同期した「サービング DB」を置き、エージェントの負荷を本番から切り離す構成を提言した。受け皿には、元の DB に合わせて AlloyDB for PostgreSQL や Oracle Database@Google Cloud、分析なら BigQuery を選ぶ
- 新規システムでは、スケールするデータベース、MCP Toolbox for Databases による権限と接続の制御、Knowledge Catalog によるコンテキストの付与の3つを最初から考えておくべきだとした
目次
Google Cloud は2026年11月18日、データと AI をテーマにしたイベント「Data & AI Summit '26 Fall」を Google 渋谷オフィスとオンラインで開いた。Track 3 の17時05分からのセッション「AI エージェントがもたらすデータベース要件の変化と、Google Cloud による解決アプローチ」には、Google Cloud の Database Sales Specialist / 事業開発部長、大久保 順氏が登壇した。AI エージェントがデータベースに与える負荷の特徴から入り、既存システムと新規システムのそれぞれについて、データベースの構成の考え方を示した。

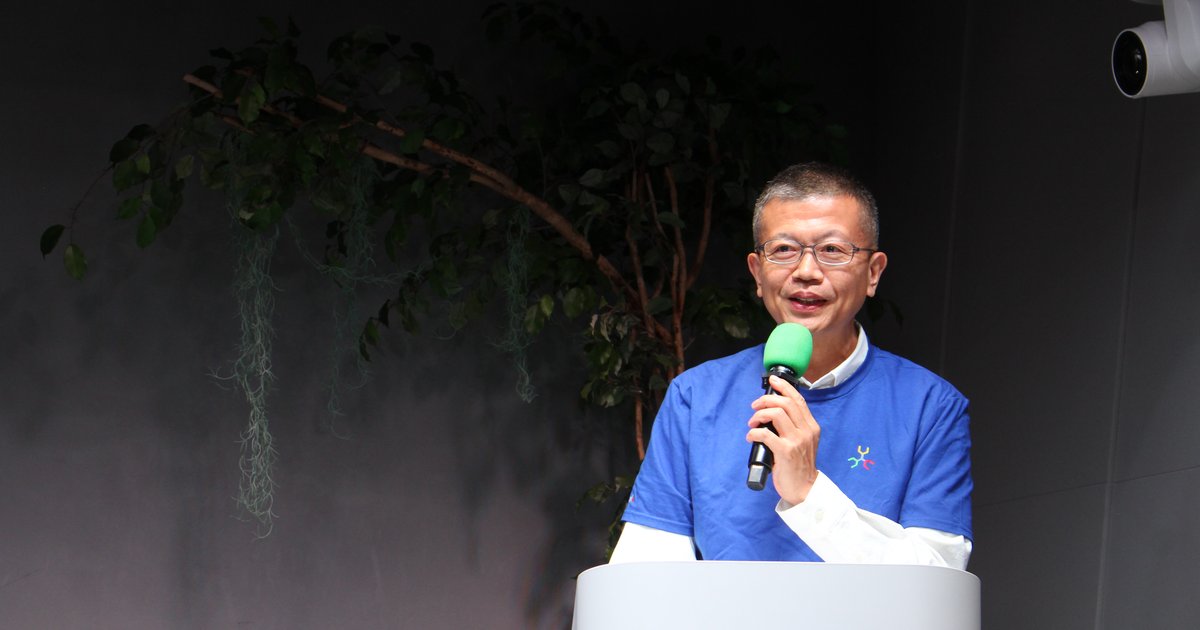
Google Cloud Database Sales Specialist / 事業開発部長の大久保 順氏
AI エージェントのアクセスは「読めない」
大久保氏はまず、データベースの使われ方の変化から話を始めた。これまでのアプリケーションは、設計者が処理の内容をあらかじめ決め、データベース側もそのスキーマに合わせてインデックスを張るなどのチューニングをしておく。アプリケーションは設計どおりのクエリを投げる。データベースは、定型のトランザクションを確実に記録するためのものだった。
AI エージェントの時代になって一番変わったのは、「AI エージェントが試行錯誤をするので、データベースを設計したときの意図どおりにアクセスしてくれるとは限らない」点だと大久保氏は言う。スライドでは、データベースの役割が「トランザクションの安全な保管庫」から「AI が自律推論する知的基盤」へ移るとし、AI エージェントが実業務で価値を出すには「新鮮な本番データ」へのアクセスが必要だが、エージェントをそのまま既存の基幹 DB につなぐと技術的な課題が出てくる、と整理していた。

データベースの役割は「トランザクションの安全な保管庫」から「AI が自律推論する知的基盤」へ
具体例として示されたのが、受注・在庫のシステムだ。従来は、担当者が画面で注文番号などの検索条件を指定し、それに応じて事前にチューニングした SQL が流れる。データベースへの負荷はおおよそ読めて、サイジングもでき、クエリの実行時間も想定の範囲に収まる。
ところが AI エージェントに「配送遅延中の大口顧客を調べ、代替在庫と対応案を出して」と頼むと、データベースから見た景色は一変する。エージェントは機械の速さで試行錯誤を繰り返し、短時間に大量の SQL を投げる。目的だけを与えられた AI は、スキーマの設計者から見れば「お行儀の悪い」重い SQL、たとえばインデックスが効かずフルテーブルスキャンになるクエリも普通に作る。さらに親エージェントがサブエージェントを並列に生み出せば、アクセスはもう一段増える。スライドの例では、特定した15社の代替倉庫・在庫引当を15並列で同時に実行し、CPU、I/O、コネクション数がスパイクして本番の OLTP データベースのリソースを圧迫する様子が描かれていた。

人間の「1回の質問」が、データベース側では高速リトライ、多段 JOIN、並列バーストを引き起こす
大久保氏は、AI エージェントのアクセスの特徴を4つにまとめた。目的に向けて試行錯誤を繰り返す「探索的な試行錯誤ループ」、それを秒単位で回す「マシンペースの試行速度」、サブエージェントの派生で並列度がどこまで上がるか分からない「予測不能な並列度とバースト」、そして OLTP の目線で「行儀の悪い」クエリだ。スライドは、推論のための参照(SELECT)クエリだけでも、この4つの特性によって既存の基幹 DB を容易に圧迫すると指摘していた。

AI エージェントのアクセスは、人間の定型クエリを前提にした OLTP データベースの想定を4つの軸で超える
レプリカや共有ストレージでは解決しきれない
それならデータベースを拡張すればよい、と考えたくなるが、大久保氏は「一筋縄ではいかない」と話す。スライドでは、よくある3つの構成の限界を並べていた。
① 本番のプライマリ DB に直接アクセス
重い JOIN やスキャンが CPU と I/O を占有し、コネクションの枯渇でアプリケーションが接続エラーになる。エージェントの負荷が既存の業務に影響し、分離が崩れる。
② 独立したリードレプリカ
レプリカの追加には時間がかかり、瞬間的なバーストに間に合わない。エージェントを待たせることになる。逆にあらかじめ増やしておけば、使わない時間も費用がかかる。
③ 共有ストレージ / キャッシュ型
ノードを増やしても、本番と同じストレージの I/O を取り合う。共有層が飽和すると性能が大きく落ち、キャッシュミスのときには遅延も出る。
※スライド「既存の DB・レプリカ構成が抱える構造的なジレンマ」と大久保氏の説明をもとに編集部が整理
③について大久保氏は、Google が社内でこのアーキテクチャを検証したところ、アクセスが集中すると共有ストレージの処理性能が足りなくなり、急に性能が落ちたと説明した。スライドの脚注によれば、オブジェクトストレージと共有ブロックストレージを組み合わせた市販のデータベースで、リードレプリカを最大8台まで追加した検証の結果で、性能は75%以上急落したという。Google Cloud の公式ブログでも、この検証の結果が紹介されている[1]。

従来型のレプリカも共有ストレージ型も、「完全分離・低遅延・秒単位の伸縮」を同時に満たすのは難しい
そこから導かれる方針は、スライドの言葉でいえば、既存システムは「本番からの物理分離」を優先し、新規の構築は「瞬時の伸縮まで満たす基盤」で組む、というものだ。
既存システムの現実解は「サービング DB + CDC」
既存システムについて大久保氏が提言したのが、「サービング DB」と CDC(チェンジデータキャプチャー)によるワークロードの分離だ。既存の本番データベースはオンラインもバッチも抱えており、障害が起きれば業務に大きな影響が出る。だから AI エージェントには、本番のデータベースへ直接アクセスさせない。代わりに、本番 DB の変更差分を CDC で常に取り込んで同期する、エージェント専用の受け皿となるデータベースを置く。これがサービング DB だ。
スライドでは、既存のアプリケーションには手を入れず、本番の SLA も保ったまま、「クエリ負荷の物理分離」と「秒〜分単位のデータ鮮度」を両立する現実解だと位置づけていた。

既存のアプリケーションは無改修のまま、CDC で同期したサービング DB へエージェントの負荷を分ける
サービング DB の選び方について、大久保氏は「あくまでも一案」と断ったうえで、既存の OLTP データベースと同じ種類が使えるなら、型変換などを考えずに済むので一番素直だと話した。スライドでは、元の DB や用途ごとに次のように整理していた。
| 既存のソース DB / 用途 | サービング DB | CDC の手段 | 選ぶ理由 |
|---|---|---|---|
| PostgreSQL(オンプレミス・他クラウド) | AlloyDB for PostgreSQL | 論理レプリケーション(pglogical)、Datastream + Dataflow など | PostgreSQL 互換で型変換が要らない(DDL の追随は別途考える)。カラムナエンジンと ScaNN で検索を速くできる |
| Oracle(Exadata・オンプレミス) | Oracle Database@Google Cloud の Autonomous AI Database | Oracle GoldenGate | 型変換が要らず、View や VPD も流用できる。自動スケールと Select AI を備える |
| 長期履歴のトレンド集計、全社横断の大規模ログ分析 | BigQuery | Datastream、BigQuery Data Transfer など | 数年分の履歴のスキャン・集計に強い。サービング用の RDB との連携も有効 |
※スライド「サービング DB の選定指針(ソース DB・用途別の最適解)」をもとに編集部が整理。Oracle の行のサービング DB は、スライドの「Oracle AI Database@Google Cloud Autonomous AI Database (ADB)」を Google Cloud のドキュメントのサービス名[2]に合わせて表記
PostgreSQL の場合の受け皿として、大久保氏は AlloyDB for PostgreSQL の特徴を3つ挙げた。1つ目は 100% PostgreSQL 互換で、使い始めるハードルが低いこと。2つ目は「行儀の悪い」クエリに強いことで、インデックスが効かない検索に対しても、データを列方向で持って高速に集計する仕組みで比較的柔軟に対応できる。3つ目は、まずサービング DB として使い始め、将来は本番の基幹 OLTP も AlloyDB に切り替える、という段階的な移行の道筋にもなることだ。

Read Pool インスタンス、カラムナエンジン、ScaNN によるベクトル検索で、エージェントの非定型クエリを受け止める
ここから先の説明は撮影していないため、画像は掲載していない。内容は会場の音声をもとにまとめた。Oracle Database を使っている場合は、Oracle Cloud やオンプレミスの Exadata などで動くデータベースから、GoldenGate で Google Cloud 上の Autonomous AI Database にサービング DB を置く構成を勧めた。大久保氏は、Oracle と Google Cloud が提携しているため、OCI 上で Exadata や Oracle Database を動かしている場合は、この連携で Google Cloud へのデータ転送の料金がかからないメリットもあると述べた。なお、2024年6月の両社の提携発表では、両社のクラウドを結ぶ Oracle Interconnect for Google Cloud で、クラウド間のデータ転送料金なしに汎用のワークロードを展開できると案内されている[3]。このほか、データウェアハウスとして BigQuery にデータを蓄積している場合や、複数のシステムのデータを掛け合わせて AI エージェントに分析させたい場合は BigQuery が向くとした。
大久保氏は既存システムについての話を、「今使っている本番のデータベースに直接アクセスさせるのではなく、AI エージェントと本番データベースの間にサービング用のデータベースを置く」とまとめた。
新規システムで最初から考える3つの設計要件
後半は、これから作るシステムで AI エージェントからの利用を前提にするなら、何を設計要件にすべきかという話に移った。
大久保氏が示した構成は、利用者がアクセスする AI エージェントの実行基盤があり、そのエージェントがデータベースにアクセスするというものだ。その中で考えておくべき要素として、次の3つを挙げた。
① スケールするデータベースを選ぶ
土台のデータベースには、アクセスが急に増えたときも、ゼロになったときも柔軟に対処でき、将来の負荷の増加にも合わせてスケールできるものを選ぶ。例として AlloyDB、Oracle の Autonomous AI Database、Spanner を挙げた。
② MCP Toolbox for Databases を挟む
AI エージェントに生のデータベースを直接たたかせるのではなく、MCP 経由でアクセスさせる。実行した人の権限で見える範囲のデータだけを見せる制御や、接続プーリングによって、大量の並列アクセスの負荷をこの層で吸収する。
③ Knowledge Catalog でコンテキストを渡す
テーブルにどんなデータが入っているか、列が何を意味するかといった情報を AI エージェントに渡す。コンテキストの有無で、精度もトークンの消費量も大きく変わる。
※大久保氏の説明をもとに編集部が整理。MCP Toolbox for Databases の名称は AlloyDB のリリースノートの表記[4]による
①のデータベースについて、大久保氏は、Spanner は Google 自身が最も使っているデータベースで、10億人以上が使っても落ちない規模までスケールできるものとして作られたと紹介した。Google Cloud の Spanner の製品ページでも、Gmail が数十億人のユーザー、数兆件のメールのデータを Spanner に移行した事例が紹介されている[5]。
②のアクセス制御の重要性も、大久保氏は改めて説明した。AI エージェントは試行錯誤の中で SQL を動的に作る。そのとき条件が漏れて、本来はその人の権限では見えてはいけないデータまで見えてしまう、ということは起きてはならない。また、サブエージェントが次々に生まれると並列度が上がり、データベースクラスターに設定した接続数の上限を超えてエラーになりかねない。MCP サーバーを挟むことで、権限を適切に絞り、接続数もそこで制御できるという。
大久保氏は、AI エージェントのためのデータベースに求められる原則として、次の3つを挙げた。
- ワークロードの分離:定型的な OLTP のワークロードと、どこまで増えるか分からない AI エージェントのワークロードを分ける
- レイテンシー:エージェントの要求にすぐ結果を返さないと、「AI に頼んでも回答が返ってこない」というユーザー体験になってしまう
- スケール:並列度が非常に大きくなる可能性に備える
エージェント向けの新機能:PostgreSQL for agents in AlloyDB と AlloyDB Express
この3つの原則に応える新機能として紹介されたのが、AlloyDB の「PostgreSQL for agents in AlloyDB」だ。2026年11月19日時点でプレビューとして提供されている[6]。大久保氏によると、本番のワークロードと AI エージェントからのアクセスをデータベースのインフラのレベルで分離したうえで、エージェント側を数千の規模まで自在に伸縮できる。
大久保氏が説明したアーキテクチャの概念図では、一方に本番用の AlloyDB で動く定型の OLTP 処理があり、もう一方に業務データへバーストでアクセスするエージェント群が並ぶ。数十、数百、場合によっては千ものエージェントが並列にアクセスするイメージだという。これを支えるのが、土台にある Google の分散ストレージ「Colossus」だ。大久保氏は、Google が検索や YouTube、Gmail で何十億人ものアクセスを支えられる「最大の秘密」がここにあり、これがバックエンドにあるので AlloyDB は AI エージェントのアクセスパターンにも耐えられると説明した。Google Cloud の公式ブログでも、AlloyDB の永続化の層は、Google 検索や YouTube、Gmail などを支えるエクサバイト規模の分散ストレージ Colossus の上に作られているとしている[1]。
もう一つ紹介されたのが「AlloyDB Express」だ。最近は AI に指示してプログラムを書いてもらう開発が増えているが、そのたびにデータベースを用意するのは意外と手間がかかる。大久保氏によると、AlloyDB Express は AI エージェントが「データベースを作って」と頼めば2秒ほどで立ち上がり、作業が終わればすぐに捨てられる。使っていないときはゼロになるので費用もかからず、セキュリティの仕組みは AlloyDB と同様のものを備える。バイブコーディングで作ったアプリケーションを本番用のクラスターに移したいときも、ワンクリックで上げられるという。
AlloyDB Express は2026年11月4日からプレビューとして提供されている。公式ドキュメントによると、公開 DNS 経由なら約2秒で接続を受け付けられる状態になり、アイドル時はコンピュートがゼロまで縮小する。1回の操作で AlloyDB のクラスターにアップグレードすることもできる[7]。大久保氏は「AI でアプリケーション開発をされる方には、ぜひ試していただきたい」と呼びかけた。
コンテキストがなければ、賢い LLM も新入社員に負ける
最後に大久保氏が力を入れたのが、コンテキストの話だ。AI エージェントが試行錯誤をすると、データベースに負荷がかかるだけでなく、もっともらしい間違った答え、いわゆるハルシネーションを作ってしまうこともある。
大久保氏はこれを「新入社員のパラドックス」という例え話で説明した。人間の新入社員は、先輩が作った設計書や手順書、先輩からの助言といったコンテキストを踏まえて作業すれば、時間はかかっても正しい答えにたどり着ける。一方、最新の LLM は非常に賢いが、コンテキストを与えられないと、手に入る情報をあさって使おうとはするものの、「ここはこうなんだよ」という先輩の助言のような文脈までは持っていない。そのため、賢いはずの LLM が新入社員に負けることが起こりうるという。
LLM が賢いと言っても、コンテキストを与えないことによって、賢い LLM が新入社員に負けてしまうということが起こり得ます。
コンテキストがない状態では、AI エージェントはまずテーブル定義を確かめ、データをサンプリングで取り出して、このデータは何だろうと推測するところから始める。それでは、トークンがどんどん消費され、作業にも時間がかかる。何度も試行錯誤させれば、データベースへの負荷も高まる。
そこで役立つのが Knowledge Catalog だと大久保氏は言う。うまくできているのは、AI エージェントが試行錯誤した結果も Knowledge Catalog に反映でき、あるエージェントが覚えたコンテキストが部署のほかの人にも役立つなら、それを展開することもできる点だという。大久保氏は「必ず使いなさいというわけではない」としつつ、AI エージェントでシステムを活用するなら、何らかのコンテキストを与える層があるかどうかで結果が違うと強調した。
その効果として紹介されたのが、Google の社内ベンチマークの結果だ。コンテキストを与えた場合は、与えない場合と比べて結果の精度が約4倍になり、作業の時間は最大33%短く、トークンの消費量は最大75%少なかったという。Google Cloud の公式ブログも、社内ベンチマークの結果として同じ数字を紹介している[8]。

「コンテキストを与える層」の重要性を説く大久保氏(写真は講演の冒頭に撮影)
大久保氏は講演を次のようにまとめた。既存のシステムでは、本番のデータベースに直接アクセスさせるより、AI エージェントの受け皿になるサービング DB を置く。新規のシステムでは、AI エージェントがアクセスしてくる前提で、スケールするデータベースを選ぶ。そして、MCP Toolbox for Databases のような権限と接続を守る層と、AI エージェントにコンテキストを与えることは、既存システムにサービング DB を置く場合にも共通して重要になる。
AI エージェントに本番データを使わせるときは、負荷を本番から切り離す(サービング DB)、アクセスを絞る(MCP の層)、文脈を渡す(コンテキストの層)の3つを、データベースの設計の段階から考えておく。
登壇者
Database Sales Specialist / 事業開発部長
開催概要
| イベント | Data & AI Summit '26 Fall(主催:Google Cloud) |
|---|---|
| 開催日 | 2026年11月18日(水) |
| 会場 | Google 渋谷オフィス+オンライン配信 |
| セッション | 【Track 3】AI エージェントがもたらすデータベース要件の変化と、Google Cloud による解決アプローチ |
| 登壇 | 大久保 順氏(Google Cloud Database Sales Specialist / 事業開発部長) |
出典:Data & AI Summit '26 Fall 公式ページ
References
- Google Cloud ブログ「A new, no-compromises database architecture for the agentic era」(Amit Ganesh、Sailesh Krishnamurthy). https://cloud.google.com/blog/products/databases/alloydbs-agentic-database-architecture(参照 2026-11-19)
- Google Cloud ドキュメント「Oracle Database@Google Cloud overview」. https://docs.cloud.google.com/oracle/database/docs/overview(参照 2026-11-19)
- Google Cloud プレスコーナー「Oracle and Google Cloud Announce a Groundbreaking Multicloud Partnership」(2024年6月11日). https://www.googlecloudpresscorner.com/2024-06-11-Oracle-and-Google-Cloud-Announce-a-Groundbreaking-Multicloud-Partnership(参照 2026-11-19)
- Google Cloud「AlloyDB for PostgreSQL release notes」. https://docs.cloud.google.com/alloydb/docs/release-notes(参照 2026-11-19)
- Google Cloud「Spanner」製品ページ. https://cloud.google.com/spanner(参照 2026-11-19)
- Google Cloud ドキュメント「PostgreSQL for agents in AlloyDB」. https://docs.cloud.google.com/alloydb/docs/postgresql-agents-alloydb(参照 2026-11-19)
- Google Cloud ドキュメント「AlloyDB Express overview」. https://docs.cloud.google.com/alloydb/docs/express-overview(参照 2026-11-19)
- Google Cloud ブログ「Introducing the new self-learning context enrichment capabilities in Knowledge Catalog」(Firat Elbey、Vasiya Krishnan). https://cloud.google.com/blog/products/data-analytics/knowledge-catalog-self-learning-context-enrichment-for-ai-agents(参照 2026-11-19)
Data & AI Summit '26 Fall のほかのレポート
- 【総括】AI エージェントに任せる前に、データに「意味」を Google Cloud と登壇10社が示したデータ基盤の条件
- 【基調講演】AIエージェントは「信頼」と「コスト」で選ばれる、Google Cloud・KDDI・MBKデジタルが示すデータ基盤の条件
- 【Track 1】AIエージェントは「初日の新入社員」 Google Cloud 山田氏が説く、データを動かさない「SOAP」アーキテクチャとコンテキスト運用
- 【Track 1】キリンビール営業部門、商談の質問に AI でその場で回答 BigQuery と Looker で約12週間で本番へ
- 【Track 1】三菱ケミカルが M365・AWS・ServiceNow を Google Cloud でつなぎ、ヘルプデスクを自律化
- 【Track 1】Google Cloud が示すエージェントのデータ基盤、BigQuery と Knowledge Catalog の役割
- 【Track 2】メルカリが dbt platform へ移行、AI エージェントでデータ基盤の運用を自律化
- 【Track 2】G-gen が検証、BigQuery に表と列の説明と業務用語を書くと AI の正答率は17%から100%に
- 【Track 2】LegalOn Technologies、Agent Skill で現場にデータ基盤を渡し「構造」で守る運用
- 【Track 3】Google Cloud が解説、BigQuery と Iceberg の使い分け 4つのテーブル形式と3つの連携パターン
- 【Track 3】ダイニーが AI エージェントを社内向けと社外向けで設計し分ける理由、誤答の影響で「LLM に任せる範囲」を決める
- 【Track 3】Google Cloud が語る「見る BI」の先 Looker で AI と会話し、作らせ、エージェントから使う
- 【Track 3】MIXI が Looker の会話分析をサブエージェントに、アナリストが自ら育てる「モンスト」の社内分析 AI
本イベントのほかのレポートも公開しています
この記事では Track 3 の Google Cloud によるデータベースのセッションを取り上げました。ほかの12本のレポートは、上の一覧からご覧いただけます。(trends. 編集部)















What's New
新着記事

Googleが社内のデータシミュレーターの仕組みを紹介、短い説明から架空企業のデータと検証済みの正解の生成が可能

アストリス・アドバイザリー・ジャパン株式会社が株式 会社ジェイテックコーポレーション(証券コード:3446)に関する2027年3月期1Q決算アップデートレポートを発行

1月13日(水) AndTech「広視野・高精細化・小型軽量化を実現するXR・AR用ヘッドマウン トディスプレイの光学設計とレーザ網膜投影技術」Zoomセミナーを開講予定

1月13日(水) AndTech「光電融合・CPO向け光コネクタ・光導波路の開発と周辺材料への 要求特性・信頼性評価」Zoomセミナーを開講予定

