


メルカリが dbt platform へ移行、AI エージェントでデータ基盤の運用を自律化
公開:
AI の活用が広がり、誰もがデータ変換のコードを書けるようになった。そのとき、データ基盤の運用はどう変わるべきか。
Google Cloud の「Data & AI Summit '26 Fall」で、メルカリのリュウ シエン氏と dbt Labs の伊藤俊廷氏が登壇し、メルカリが dbt Core から dbt platform へ移行した経緯と、その後に AI エージェントを組み合わせて運用を自律化した3つの事例を紹介した。導入時の検討ポイントから、ジョブ監視の自動化、Terraform による環境構築のセルフサービス化、ナレッジ DB で AI の「解釈」をそろえる工夫まで、現場の具体的な設計が語られた。
この記事の要点
- メルカリでは AI の活用で dbt を使う人とチームが急増し、Docker の独自管理、1つのリポジトリでのレビュー集中、環境の追加の難しさが課題になった。dbt platform への移行で、これらを解消した
- 導入の決め手はセキュリティ基準を満たす WIF 認証への対応。既存の Argo Workflows は API で dbt platform とつなぎ、CI は dbt platform の機能で作り直した
- 導入後は、ジョブ失敗の調査を AI エージェントに任せ、環境構築を Claude の Skill と Terraform で半自動化し、Looker のセマンティックレイヤーと Notion のナレッジ DB で「定義」と「解釈」の精度をそろえた
目次
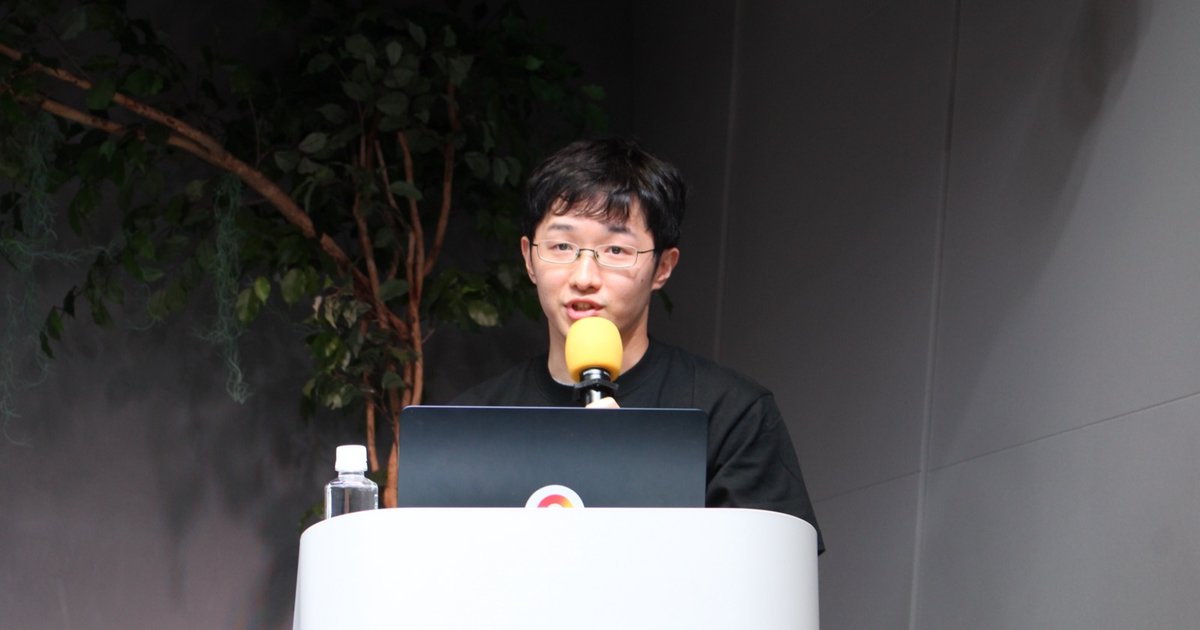
Google Cloud は2026年11月18日、データと AI をテーマにしたイベント「Data & AI Summit '26 Fall」を Google 渋谷オフィスとオンラインで開いた。Track 2 の最初のブレイクアウトセッション「dbt platform でデータ変換を効率化: メルカリから学ぶ検証ポイントと分析エージェント活用」には、株式会社メルカリ Data Management チームのデータエンジニア、リュウ シエン氏と、dbt Labs の Staff Solutions Architect、伊藤俊廷氏が登壇した。伊藤氏が dbt を紹介し、リュウ氏がメルカリの導入事例を語り、最後に伊藤氏が大規模な運用の課題と解決策を補足する構成だった。

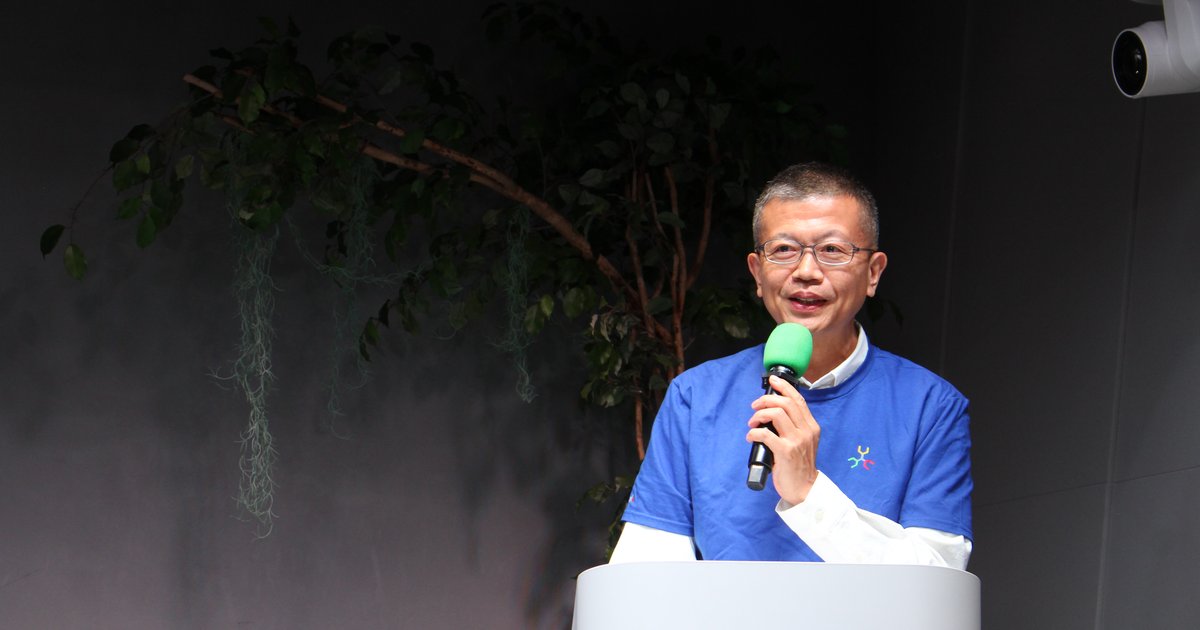
株式会社メルカリ Data Management チーム データエンジニアのリュウ シエン氏
SQL をソフトウェアのように扱う dbt
最初に登壇した伊藤氏は、dbt が解決しようとしている課題から話を始めた。BigQuery の利用者は、スケジュールドクエリやストアドプロシージャでデータを加工することが多い。そのまま使い続けると、ロジックがサイロ化し、1本が数千行の SQL になったり、処理の順序や SQL どうしの依存関係が分かりにくくなったりする。その結果、テストの仕組みも作りにくく、データの信頼性を保てない。伊藤氏は「昨今はそれを AI が見に来るので、信頼できるデータが提供できないという課題が出てきている」と指摘した。
dbt は、こうした課題をソフトウェアエンジニアリングの手法で解決する。データの変換は SELECT 文だけで組み立て、ソースデータの定義は YAML で書く。SELECT 文なので多くの人が読める共通言語になり、ref という関数でモデル間の依存関係を定義すれば、並列に実行して全体の時間を短くできる。モデルごとのテストも標準で備えており、壊れたデータを下流に渡さずに済む。この dbt のエンジンを使い、開発から運用までをマネージドで提供するのが「dbt platform」だ。伊藤氏は、dbt Labs が今年、Google Cloud の Partner of the Year を受賞したことも紹介した[1]。なお、この冒頭の部分は撮影していないため、画像は掲載していない。
AI の活用が広がり、dbt Core の運用が限界に
続いて登壇したリュウ氏によると、メルカリは2021年から dbt Core を使っており、700以上のモデルを約70人のコントリビューターで運用してきた。データ基盤は BigQuery で、BigQuery から生データを取り出して変換し、また BigQuery に書き込む使い方だ。dbt Core によって、SQL のロジックのコード管理、GitHub のプルリクエストによるレビュー、テストとデータの鮮度チェックによる品質管理、リネージによる依存関係の可視化を実現してきたという。
転機になったのは、メルカリが去年から全社で進める「AI-Native」の方針だ。リュウ氏によると、全社員が価値を生み出せる環境をつくるこの取り組みで AI の活用が急増し、dbt を使うハードルが大きく下がった。各チームから個別の dbt 環境を求める声も急増し、従来の dbt Core の運用体制では次の3つの課題が表面化した。
① インフラ管理の複雑さ
dbt を実行する Docker を独自に管理しており、バージョンアップのたびに1週間以上の対応時間がかかっていた。
② モノレポの問題
1つのリポジトリで全モデルを管理しているため、重要度にかかわらず同じ水準でレビューする必要があり、時間がかかっていた。
③ 環境を増やしにくい
チームごとに個別の環境が欲しいという要望があっても、dbt Core で別の環境を立ち上げるのは負担が大きかった。
これらを解決するため、メルカリは dbt platform の導入を検討した。一番期待したのは、複数のリポジトリで開発できる機能だ。重要なモデルはメインのリポジトリに残し、各チーム専用のモデルはチームのリポジトリに切り出す。そうすれば、各チームが開発からリリースまでをチーム内で完結でき、Data Management チームが一つひとつレビューする必要がなくなる。
導入の決め手は WIF 認証、既存の仕組みも生かす
リュウ氏は、導入にあたって検討したポイントを2つ挙げた。
1つ目は認証の方式だ。メルカリは以前から dbt platform の導入を検討していたが、当時の dbt platform は、長期間有効な固定のサービスアカウントキーで BigQuery に接続する方式しかサポートしていなかった。キーを dbt platform 側に保管する必要があり、社内のセキュリティ基準を満たせなかったという。状況を変えたのが、dbt platform の WIF(Workload Identity Federation)認証への対応だ。外部の ID 基盤との連携で短時間だけ有効なトークンを発行し、それで BigQuery に接続する。固定のキーの発行も保管もなくなり、セキュリティ基準をクリアして「ようやく導入できた」とリュウ氏は振り返った。
2つ目は、既存のバッチ管理の仕組みとの連携だ。メルカリはこれまで Argo Workflows で dbt のジョブを動かし、作り込みもしてきたため、dbt platform 標準のスケジューラーへすぐには乗り換えられなかった。そこで、Argo Workflows から dbt platform の API を呼んでジョブを起動し、そのジョブが BigQuery にアクセスする構成にした。これまでの仕組みを生かしながら、dbt platform の利点も取り込めたという。
導入後には、CI 環境の作り方も検討した。元の CI をそのまま移すのではなく、dbt platform の API、CI ジョブ、一時的なスキーマの機能を組み合わせた。アナリストが GitHub でブランチを切って修正をプッシュすると、dbt platform の CI ジョブが BigQuery に専用の環境を作り、修正した分のデータだけを書き込む。本番のデータに影響しないので、自由にデバッグできる。レビューを通って本番にマージされると、専用の環境は dbt platform が自動で削除するため、CI 環境のメンテナンスも要らなくなった。

CI は既存の仕組みを移植せず、dbt platform API、dbt CI Job、Temporary schema の機能で作り直した
導入の効果:工数削減、アナリストの自律化、AI-native 化
リュウ氏は、dbt platform の導入ですぐに見えた効果として3つを挙げた。
インフラ運用工数の削減
Docker イメージの独自管理や並行運用がなくなり、従来1週間以上かかっていたバージョンアップ対応が不要になった。
アナリストの自律化
アナリストのチームがスケジュールドクエリの dbt モデル化を自分たちで進め、レビューもチーム内で完結できるようになった。
AI-native 化への貢献
テーブル作成からセマンティックレイヤーの定義、BI ツールや分析エージェントの活用までを滑らかにつなげられた。

dbt platform 導入の効果
AI エージェントで運用を自律化する
後半は、導入後の活用事例が3つ紹介された。最初の2つは、データエンジニアに集中していた運用の仕事を、AI エージェントの力を借りて手放していく取り組みだ。
活用①:ジョブ監視の民主化
これまでは dbt のジョブが失敗しても、届く通知は「失敗した」という事実だけで、原因は自分で調べるしかなかった。調べるにはエンジニアが dbt のログを手作業で掘り下げる必要があり、手間が大きい。チームやプロジェクトが増えるにつれ、どのドメインの誰が対応すべきかの切り分けも難しくなっていた。

ジョブが失敗したときの「調査の属人化」と、初動の遅れが課題だった
そこでメルカリは、dbt の Webhook を起点にした仕組みを作った。流れは次のとおりだ。
- dbt のジョブが失敗すると、Webhook がイベントを社内の Cloud Functions に送る
- Cloud Functions が失敗ログからエラーの内容を抜き出して整理し、Firestore に保存した担当チームの設定と照らし合わせて転送先を決める
- GitHub Actions を通じて、担当チームの Slack チャンネルにアラートを送る
- 担当者はアラートを見て AI エージェントに調査を頼み、根本原因と復旧の方法を受け取る
アラートにはエラーのコンテキストがすべて含まれているため、担当者は AI エージェントに「調査して」と頼むだけで、原因と対応の方針がもらえる。リュウ氏によると、手作業の調査はほぼなくなり、アラートは担当チームに直接届くようになった。復旧のコマンドは AI が提示するが、実行するのは人が確認してから。安全性も保っている。

失敗ログの抽出、Slack への転送、エージェントへの調査依頼、原因特定と復旧提案の4段階

復旧のコマンドは AI が提示し、実行は人が確認してから行う
活用②:新規の環境構築の半自動化
dbt platform の導入後も、環境の追加や権限付与の依頼はデータエンジニアに集中し、分析チームの初動を遅らせるボトルネックになっていた。UI から手作業で設定するため、staging と本番など環境ごとに微妙な差が出て再現性が低く、変更の履歴が残らないので監査の面でもリスクがあったという。
解決に使ったのは、AI エージェントと、dbt platform の公式の Terraform プロバイダーだ。アナリストがプロジェクト名を伝えると、Claude の Skill が内製のスクリプトを呼び出し、Terraform の設定ファイルとプルリクエストを自動で作る。Data Management チームは生成された内容をレビューして承認するだけで、マージされると dbt platform に設定が反映される。
工夫したのは、AI に設定ファイルを直接書かせないことだ。内製のスクリプトには Jinja のテンプレートを用意してあり、AI から受け取った値をテンプレートの変数に当てはめて設定ファイルに変換する。リュウ氏は、こうすることで AI の生成による微妙な差を防げると説明した。スライドによれば、数日かかっていた dbt の環境構築が、数分の AI との対話で終わるようになった。

AI Agent と Terraform を連携させ、対話形式で dbt の環境を構築する
あわせて、何を Terraform で管理し、何を UI で扱うかのルールも決めている。
| 比較項目 | Terraform で管理 | UI で扱う |
|---|---|---|
| 対象 | 再現性・レビュー・監査追跡が必要な設定 | 設定を変えない確認・調査 |
| 例 | プロジェクト/環境/ジョブの設定、権限・ユーザーグループのアクセス管理、変更履歴のレビューと監査追跡 | 実行ログの確認、ジョブの手動実行、設定変更を伴わない確認・調査 |
※スライド「活用② 新規の環境構築の半自動化|Tips:Terraform と UI」をもとに編集部が整理
「定義の精度」と「解釈の精度」をそろえる
3つ目の事例は、プロダクト分析の精度を高める取り組みだ。リュウ氏が挙げた課題は3つある。分析のロジックが個人のスケジュールドクエリやスプレッドシートに散らばり、Git で管理されていなかったこと。分析者ごとに指標の定義が違い、毎回 SQL を書いて確かめていたこと。そして、定義がそろっても、施策やセグメントの文脈がないと、AI がもっともらしく誤った解釈をしてしまうことだ。
メルカリは2つの面から手を打った。1つは「定義の精度」だ。dbt platform で分析用のデータをモデルにまとめ、Looker でセマンティックレイヤーを定義して、指標の公式な計算式をそこに集約した。誰が集計しても同じ結果になる。BI エージェントは、この Looker の定義を使って集計する。
もう1つは「解釈の精度」だ。集計の結果をどう読むかは人によって変わる。そこで、アナリストの暗黙知を Notion の表に書き出した「ナレッジ DB」をつくった。施策のタイムライン(この変化はどの施策の影響か)、セグメントの特性(このセグメントは元々そういう動きか)、過去の分析の知見(同じことはすでに分かっているか)をまとめ、BI エージェントは集計結果を解釈するときにこれを参照する。リュウ氏によると、これで解釈の差がなくなったという。

dbt でデータモデルと定義を固め、集計結果の解釈にはナレッジ DB を参照させる
指標の計算式(定義)をそろえるだけでは、AI は数字を正しく読めない。施策の時期やセグメントの特性といった、アナリストの頭の中にある文脈も書き出して渡すことで、解釈の精度までそろう。
リュウ氏は最後に、全体を3つにまとめた。WIF 認証と Argo Workflows との連携による安全で効率的な基盤の刷新。AI エージェントによる障害調査と、Terraform と AI による環境構築のセルフサービス化で進めた運用・開発の自律化。そして dbt と Looker による定義の精度と、Notion のナレッジ DB による解釈の精度を両立したプロダクト分析の高精度化だ。今後は、モデルの増加に伴う開発者体験や実行速度の課題に向けて、高速なコンパイルでチームごとの自律的な開発を支える Fusion(dbt v2)の導入を検討するという。

dbt platform 導入による基盤刷新から運用の自律化、そして文脈を踏まえた高精度な分析へ
モノレポの限界と dbt Mesh
セッションの最後に、伊藤氏が再び登壇し、メルカリの事例にもあったモノレポからマルチレポへの移行について補足した。dbt が使いやすいほどモデルは増え、1つのリポジトリに数百から千ほどのモデルがたまっていく。プルリクエストは常にたくさん開き、それを中央の1チームがすべてレビューしなければならない。
伊藤氏はこの課題を3つに分けた。変更を承認できる人が限られてボトルネックになり、モデルが増えるとビルドや CI も遅くなる「承認」の問題。誰がレビューし、共通部品をどのチームが担当するのかが曖昧になる「責任範囲」の問題。そして、あるモデルを直すと下流の全体に影響し得るのに、規模が大きすぎて見通せない「下流への影響」の問題だ。
プロジェクトを分けてパッケージとして取り込むやり方もあるが、下流の各プロジェクトが同じモデルを取り込むため、同じモデルがいくつもできてしまい、根本的な解決にはならないという。dbt Labs はこれを「dbt Mesh」で解決している。上流のモデルは基本的に非公開にしておき、必要なモデルだけを公開して、バージョンも分けられる。下流のプロジェクトは、自分のプロジェクトにあるかのように ref で参照し、その上に自分たちのモデルを作る。モデルの「コントラクト」で列の構成を固定すれば、チーム間で決めた形が必ず守られるようにもできる。

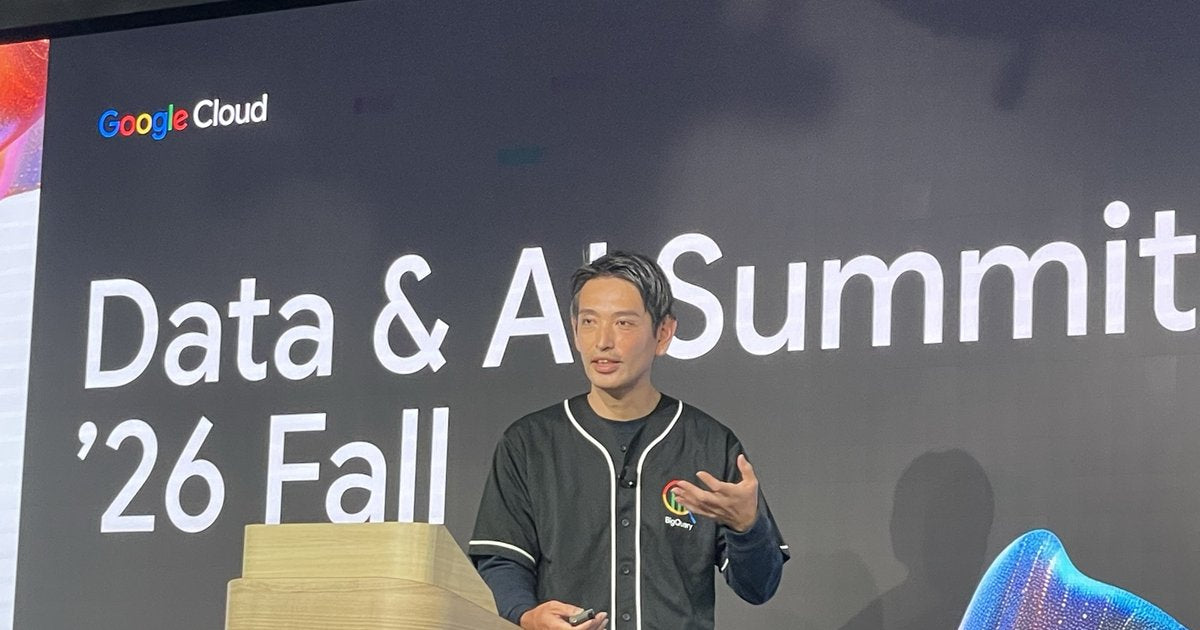
モノレポの課題と dbt Mesh を解説する dbt Labs の伊藤俊廷氏
登壇者
Data Managementチーム データエンジニア
Staff Solutions Architect
開催概要
| イベント | Data & AI Summit '26 Fall(主催:Google Cloud) |
|---|---|
| 開催日 | 2026年11月18日(水) |
| 会場 | Google 渋谷オフィス+オンライン配信 |
| セッション | 【Track 2】dbt platform でデータ変換を効率化: メルカリから学ぶ検証ポイントと分析エージェント活用 |
| 登壇 | リュウ シエン氏(株式会社メルカリ Data Managementチーム データエンジニア) 伊藤俊廷氏(dbt Labs Staff Solutions Architect) |
出典:Data & AI Summit '26 Fall 公式ページ
References
- dbt Labs「dbt Labs wins 2026 Google Cloud Partner of the Year award」. https://www.getdbt.com/blog/dbt-labs-wins-2026-google-cloud-partner-of-the-year-award(参照 2026-11-19)
Data & AI Summit '26 Fall のほかのレポート
- 【総括】AI エージェントに任せる前に、データに「意味」を Google Cloud と登壇10社が示したデータ基盤の条件
- 【基調講演】AIエージェントは「信頼」と「コスト」で選ばれる、Google Cloud・KDDI・MBKデジタルが示すデータ基盤の条件
- 【Track 1】AIエージェントは「初日の新入社員」 Google Cloud 山田氏が説く、データを動かさない「SOAP」アーキテクチャとコンテキスト運用
- 【Track 1】キリンビール営業部門、商談の質問に AI でその場で回答 BigQuery と Looker で約12週間で本番へ
- 【Track 1】三菱ケミカルが M365・AWS・ServiceNow を Google Cloud でつなぎ、ヘルプデスクを自律化
- 【Track 1】Google Cloud が示すエージェントのデータ基盤、BigQuery と Knowledge Catalog の役割
- 【Track 2】G-gen が検証、BigQuery に表と列の説明と業務用語を書くと AI の正答率は17%から100%に
- 【Track 2】LegalOn Technologies、Agent Skill で現場にデータ基盤を渡し「構造」で守る運用
- 【Track 3】Google Cloud が解説、BigQuery と Iceberg の使い分け 4つのテーブル形式と3つの連携パターン
- 【Track 3】ダイニーが AI エージェントを社内向けと社外向けで設計し分ける理由、誤答の影響で「LLM に任せる範囲」を決める
- 【Track 3】Google Cloud が語る「見る BI」の先 Looker で AI と会話し、作らせ、エージェントから使う
- 【Track 3】Google Cloud が提言、AI エージェントから本番 DB を守る「サービング DB」と3つの設計要件
- 【Track 3】MIXI が Looker の会話分析をサブエージェントに、アナリストが自ら育てる「モンスト」の社内分析 AI
本イベントのほかのレポートも公開しています
この記事では Track 2 のメルカリと dbt Labs のセッションを取り上げました。ほかの12本のレポートは、上の一覧からご覧いただけます。(trends. 編集部)















What's New
新着記事

Googleが社内のデータシミュレーターの仕組みを紹介、短い説明から架空企業のデータと検証済みの正解の生成が可能

アストリス・アドバイザリー・ジャパン株式会社が株式 会社ジェイテックコーポレーション(証券コード:3446)に関する2027年3月期1Q決算アップデートレポートを発行

1月13日(水) AndTech「広視野・高精細化・小型軽量化を実現するXR・AR用ヘッドマウン トディスプレイの光学設計とレーザ網膜投影技術」Zoomセミナーを開講予定

1月13日(水) AndTech「光電融合・CPO向け光コネクタ・光導波路の開発と周辺材料への 要求特性・信頼性評価」Zoomセミナーを開講予定

