


LegalOn Technologies、Agent Skill で現場にデータ基盤を渡し「構造」で守る運用
公開:
AI エージェントで、現場が自分でデータを整え、分析できるようになった。だが、任せる範囲を広げるほど、守りも強くしなければならない。
Google Cloud の「Data & AI Summit '26 Fall」で、株式会社LegalOn Technologies の若菜 勇気氏が登壇し、セルフサーブのデータ基盤とガバナンスを両立させる同社の運用を紹介した。データの取り込みからモデリングまでを Agent Skill で事業部に渡し、守りは機密度のラベル、権限、ネットワークの「構造」に任せる。AI エージェントが利用者本人の権限で動くことを前提にした、具体的な設計が語られた。
この記事の要点
- LegalOn Technologies は、データの取り込み・定義・dbt のモデル作成・実行環境づくりを Agent Skill にまとめ、事業部が自分で進められるようにした。各段階でプルリクエストを出し、データ基盤チームはレビューで品質と文脈を支える
- AI エージェントは利用者本人の権限で動くため、情報資産の機密度(IA レベル)をそのままラベルにし、ポリシータグ、常時権限の廃止と一時昇格、hook、VPC Service Controls、専用のセキュア環境を重ねてデータを守る
- 今後は、Skill・hook・権限の設定を Gateway/MCP の1つの入り口にまとめる構想を開発・検証中。データ基盤チームは「作る」立場から「材料を整えて見守る」立場へ移るという
目次
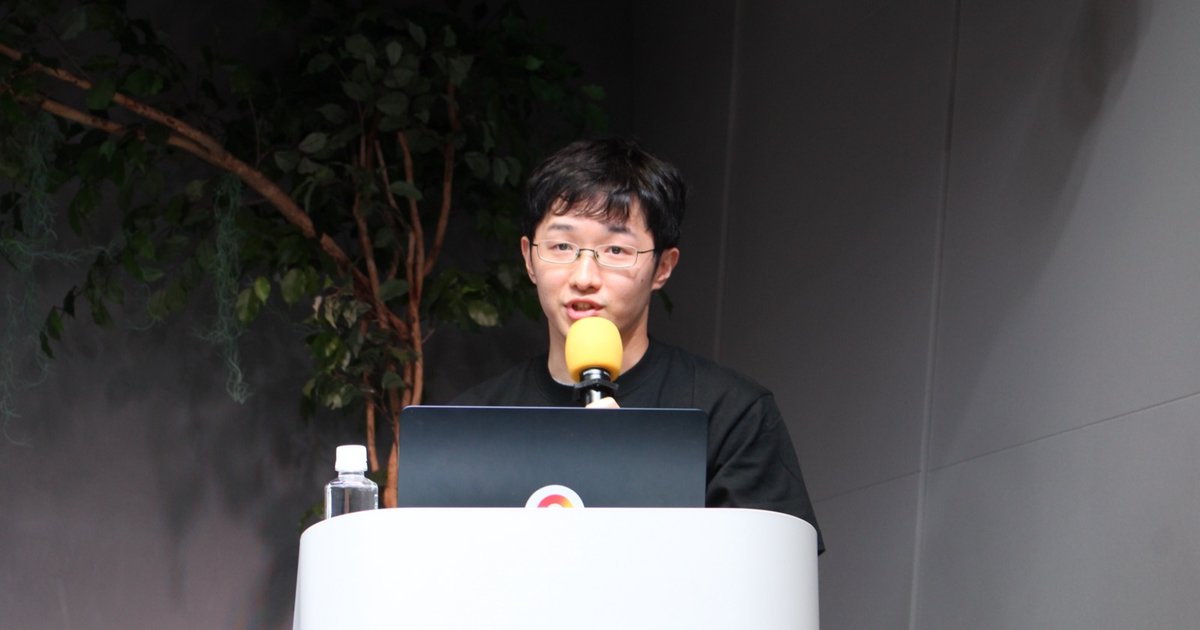
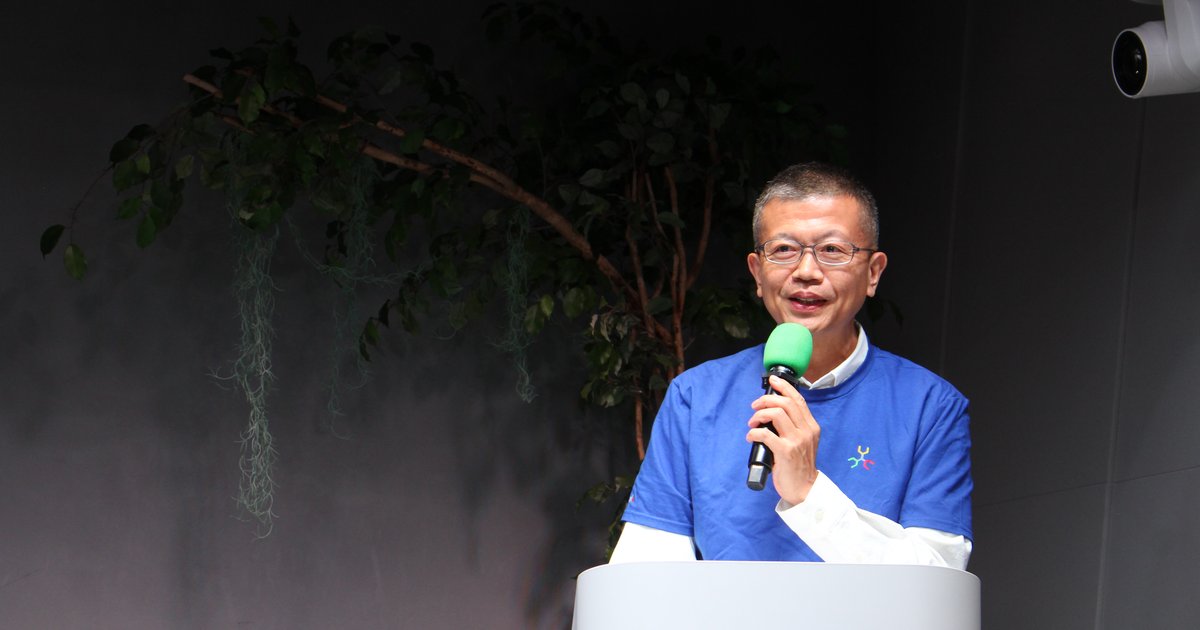
Google Cloud は2026年11月18日、データと AI をテーマにしたイベント「Data & AI Summit '26 Fall」を Google 渋谷オフィスとオンラインで開いた。Track 2 の16時25分からのセッション「AI エージェントを活用したセルフサーブのデータ基盤の運用」には、株式会社LegalOn Technologies データセクション Head of Data の若菜 勇気氏が登壇した。若菜氏は、同社でデータ分析・データ基盤・データガバナンス・セキュリティ体制を統括している。
なお、本セッションは前半(データワーキンググループと LookML の運用の紹介まで)のみ撮影しており、後半は写真を掲載していない。後半のスライドの内容は、同社が公開した登壇資料で確認した[1]。

株式会社LegalOn Technologies データセクション Head of Data の若菜 勇気氏
任せる範囲を広げるほど、守りも強くする
若菜氏は冒頭、データ基盤の運用で一番のボトルネックになるのは、実はデータ基盤のチーム自身だと指摘した。リクエストが集まるとそこが詰まる。事業部は自分でデータを整えて分析したいし、データ基盤チームを待たずに進めたい。いまは AI エージェントを使い、現場がかなりの速さで動けるようになっている。
一方で、セルフサーブはガバナンスの面で問題になることがある。AI エージェントを使うと、さまざまな経路でデータを取り出せてしまう。意図せず個人情報や機密データを参照したり、各リージョンのデータが混ざったりするおそれもある。スライドはこれを「任せる範囲を広げるほど守りも強くする必要がある」とまとめていた。

「現場に任せたい」と「事故は起こせない」を両立させるのがテーマ
同社の答えは、層を分けることだ。作業は、AI エージェント向けのスキル(Agent Skill)で現場に渡す。データを守る部分は、機密度のタグ、本人の権限、専用のセキュアな環境といった「権限とネットワークの構造」で、AI がアクセスできる範囲を制限する。そして承認と監視は人が担い、定型の作業は AI が代行する。スライドには「触れる範囲は権限とネットワークで決め、その中の作業は現場に任せる」と書かれていた。

作業を渡す層、データを守る層、運用の3層で考える
ガードレールも1か所に頼らない。同社はデータ基盤の運用を「決める・作る・使う・見直す」の4つの段階で捉え、それぞれに仕組みを置いている。
| 段階 | 置いている仕組み |
|---|---|
| ① 決める | 集計定義、データ定義、データオーナー制度、データワーキンググループ |
| ② 作る | Agent Skill、モデリングの規約、lint、AI によるレビュー |
| ③ 使う | ポリシータグ、一時的な権限の昇格、hook、専用のセキュア環境 |
| ④ 見直す | 監視・モニタリング、CSIRT への通知、使われないテーブルの棚卸し |
※スライド「ガードレールは決める・作る・使う・見直すの各段階にある」をもとに編集部が整理
見直した結果は、次の「決める」に戻す。若菜氏によると、データが悪い使われ方をしていないかはセキュリティチームの CSIRT と連携して監視し、データ基盤チームは使われないテーブルを棚卸しして、データを常にきれいな状態に保つという。
データ基盤の構成は、Google Cloud の BigQuery が中心だ。プロダクトのデータベース、Cloud Logging に集めたアプリのログ、Salesforce などの SaaS のデータを、ジョブスケジューラーの Prefect と Python で取り込み、まず生データ層に入れる。生データ層に触れられるのはデータ基盤チームだけだ。dbt で変換・整形したデータは公開層に置かれ、利用者が分析に使う。その先で Looker、セマンティックレイヤーの BI、AI エージェントがデータを使う。

データ基盤の構成(スライドには「実際はもうすこし複雑です」との注記があった)
Agent Skill で、取り込みからモデリングまでを現場に渡す
1つ目のテーマは、作業を現場に渡す仕組みだ。事業部がセルフサーブで進められるスキルには「かなり作り込みが必要になる」と若菜氏は話す。同社は、データの取り込みから定義、モデリングまでを4つの Skill で渡している。
- 取り込む:プロダクトのテーブルを BigQuery に同期する
- 定義する:集計とデータの定義を聞き取りながら YAML にする
- モデルを作る:定義から dbt のモデルを作る。モデリングの規約は Skill が持つ
- 環境を作る:エンジニアでなくても dbt を自分の PC で動かせるようにする
どの工程でも、データ基盤チームがプルリクエストをレビューし、品質と文脈を支える。

データの取り込みから定義・モデリングまでを Skill で渡す
依頼から実装までは、3段階のプルリクエストで進める。まず依頼者が「集計定義」を書く。誰が・何を・いつ・なぜなど7つの観点で Skill が聞き取り、YAML にまとめる。次に、データオーナーが、どのデータをどう集計するかを「データ定義」として YAML に書き、依頼者とデータ基盤チームが確かめる。最後に実装する人が定義から dbt のモデルを作り、ビルドとテストを通す。各段階でプルリクエストを出し、マージされるまで次の段階には進まない。

定義は YAML で書き、書く人と確かめる人を段階ごとに分ける
同じ考え方は Looker にも広がっている。若菜氏によると、Looker もデータ基盤チームが運用せず、プロダクトの開発チームが自らメンテナンスする文化ができてきた。BigQuery のスキーマから LookML の土台を自動で生成し、列の変更にも自動で追従させる。人は指標を足すだけだ。規約に沿った書き方かは Skill が確かめ、壊れた参照や書き方の誤りは Codex Review や GitHub Agentic Workflows を使った CI で機械的に判定する。最後の判断は人が行う。若菜氏は、今のところプロダクトの開発チームだけで完結していると述べた。

仕組みはデータ基盤が用意し、LookML の中身はプロダクトの開発チームが持つ
判断の責任を3つの役割に分ける
現場に任せる範囲を広げる分、同社は判断の責任を3つの役割に分けた。
① データオーナー
元データと集計の中身に責任を持つ。プロダクトのデータやドメイン知識に最も詳しい人が、使う元データと集計ロジックが正しいかを判断する。
② データ基盤チーム
置き場所と共通ルールに責任を持つ。保存先・粒度・加工・アクセス制御のルールを共通化する。
③ データワーキンググループ
機微なデータの扱いに責任を持つ。法務・契約・セキュリティをまたぐ判断を担う。
※スライド「データオーナー制度:誰が何に責任を持つか」をもとに編集部が整理
データワーキンググループは、セキュリティ委員会の分科会として設けた会合で、若菜氏がデータマネジメント責任者(議長)を務める。データを扱うには、法務やプロダクト、セキュリティ、内部監査などに広く許可や確認を取る必要があり、そのプロセスが非常に面倒だったという。そこで判断権限を持つ責任者を集め、ポリシー作りから、型にはまらない難しい判断の「判例」作りまでをここで行う。
必須のメンバーは、データマネジメント責任者、法務、セキュリティ責任者、内部監査、開発統括者で、必要に応じて開発部門の責任者やプロダクト担当、実装担当を招く。持ち込まれるのは、データ利用の型に当てはまらない使い方、新しいデータの送り先、法務・契約・セキュリティをまたぐ判断だ。判断には、データ利用を事前に評価して証跡を残す同社のプラットフォームも使っている。この取り組みは、2026年10月に同氏が登壇した別のイベントの資料でも詳しく紹介されている[2]。

現場に任せきれない判断は、判断権限を持つ責任者が集まって決める
AI エージェントは「本人の権限」で動く
2つ目のテーマは、用意したデータを AI エージェントに使わせるときの守り方だ。ここからは撮影していないため、画像は掲載していない。
若菜氏が出発点に置いたのは、Claude Code や Codex といった AI エージェントは、利用者本人が認証して使うという事実だ。エージェントは本人の権限をそのまま引き継いでデータにアクセスする。人もエージェントも「同じ扉」を通るので、本来やってはいけないことをエージェントがやってしまう場面も出てくる。しかし、利用者の手元でエージェント専用の認証を強制することはできない。そこで同社は、データのラベルと本人の属性を組み合わせたラティスモデルで権限管理を強め、AI エージェントが届く範囲を制御している。
土台は、データワーキンググループで作っている同社の「情報資産ガイドライン」だ。全社の情報資産を、機密性・完全性・可用性の観点から5段階に分けている。
| レベル | 中身 | 扱い |
|---|---|---|
| IA1(Public) | 公開してよい情報 | 制限なし |
| IA2(Private) | 社内向けの情報 | 外には出さない。社内では広く共有できる |
| IA3(Protected) | 個人情報・契約で守る情報 | 限られたグループで使う。持ち出しを制限 |
| IA4・IA5(Restricted) | 漏えいで事業に深刻な影響が出る情報 | 特定の権限者だけ。最も強い対策 |
※登壇資料のスライド「土台になる分類表:当社の情報資産ガイドライン」をもとに編集部が整理
この IA レベルを、そのままデータのラベルに使う。プロダクトのログの定義(proto ファイル)に、開発チームが項目ごとの IA レベルを書く。テーブルを作るときには BigQuery のポリシータグ[3]が自動で付き、閲覧できる人が制限される。書き漏れがあれば基盤側の一覧で補う。IA4 以上の列は機械的に外し、公開層や Looker には出さない。若菜氏によると、この自動化があるため、ログの種類が増えてもタグ付けが追いつかなくなることは今のところ起きていない。
Looker では、所属部署に応じて個人情報を見せ分けている。個人情報は BigQuery では常にマスクしているが、Looker では許可された部署にだけ元の値を見せる。人事システムから従業員の所属部署を取り込み、部署ごとに見てよいデータを決めた対応表をもとに、Looker のユーザー属性を毎日更新する。Looker は属性を見て、列ごとにマスクする。同じメールアドレスの列でも、許可された部署には元の値が、それ以外の部署には「[masked]」が表示され、BigQuery に直接 SQL を書く人にはポリシータグでマスクがかかる。
常時の権限をなくし、hook と境界で守る
権限は「かなり作り込みが必要な箇所」だと若菜氏は強調した。権限を強くすれば機密データを簡単に使えるが、しっかり作らないと、いつの間にか見てはいけない人に見られてしまう。そこで同社は、普段は人もエージェントも機密データに届かない環境にしている。
- 常時権限の廃止と一時昇格:常時の強い権限をやめ、機密レベルの高いテーブルを見たいときは PAM などを使って申請制で一時的に昇格させる。昇格中は全件を監査する。普段はマスク済みのデータしか見えない
- API キーと機密データ閲覧の「排他」:MCP 経由でコーディングエージェントがデータを取るような使い方に備え、API キーを発行した人には機密データを見せない。発行時に確認し、毎日点検する。本人の権限で動いても、MCP を経由しても、機密データには届かない
- hook で実行前に止める:コーディングエージェントが bq query や dbt のコマンドなどを実行しようとすると、hook が対象のタグを確かめて警告し、人が承認するまで実行させない
- 止められないものは見つける:個人のデータセットへの複製を記録し、監査用のビューで見える化する
※登壇資料のスライド「防止:機密データへの常時アクセスを制限する」「hookで実行前に止め、止められないものは見つける」と発言をもとに編集部が整理
スライドには「AIへのルールは読み飛ばされることがある。その前提で、仕組みで補う」とあった。若菜氏は、防げないものはモニタリングで見つけて直す、つまりガードレールのサイクルの最後にある「見直す」が重要だと述べた。
日本・米国・ドイツに拠点を持つ同社には、リージョンごとに異なる法規制という課題もある。個人情報だけでも、日本の個人情報保護法、米国のカリフォルニア州の CCPA などの州法、EU の GDPR、シンガポールの PDPA と、それぞれ独立している。データがリージョンの境界を越えた時点で問題になることが多い。そこで同社は、リージョンごとに専用のプロジェクトを分け、VPC Service Controls[4]の境界で覆って、リージョンをまたいだクエリやアクセスができないようにしている。
あわせて、データの状態ごとにできることも決めた。統計・匿名化済みで個人を特定できないデータなら、リージョンをまたいで合算できる。仮名化済みのデータは、リージョンごとに必要な人にだけ最小限の権限を付け、他のデータと結合せず、識別子はハッシュで渡す。そして IA4・IA5 は、専用のセキュア環境で強力な監視と監査をかけて扱う。
AI へのルールは読み飛ばされる前提で考える。だから、届く範囲そのものを権限とネットワークで絞り、実行前に止め、止められないものは見つける。仕組みを1つに頼らず重ねるのが、同社の守り方だ。
機密データは専用のセキュア環境で扱う
公開層から外した IA4・IA5 のデータは、出口を絞った専用の環境の中だけで扱う。若菜氏は「中の細かい話はセキュリティ上問題がある」として概要にとどめたが、スライドでは次の5つの要素が示された。
- 専用のブラウザ:決められたブラウザだけが入り口になる
- 作業環境:専用の作業用マシンにログインして作業する
- 通信の検査:専用のプロキシと監査システムが通信を検査する。中で使う AI エージェントにも専用のゲートウェイを用意し、使い方を監査する
- データの境界:VPC Service Controls で多層に守る
- 持ち出しは人が承認:統計的に加工したデータなどを外に出したいときは、PAM で一時的に承認し、記録する
※登壇資料のスライド「専用のセキュア環境で機密度の高いデータを使う」と発言をもとに編集部が整理
環境は利用者ごとに期限付きで払い出し、使い終わったら環境ごと削除する。顧客データも残らない。
面倒に思える払い出しの手続きは、実は完全に自動化しているという。利用者が Slack で目的・期間・クエリを添えて申請し、承認者がボタンを押して承認する。すると AI エージェントの Devin が設定を書いてプルリクエストを作り、人がレビューして適用する。最後に、誰が・何を・いつまで使うかが CSIRT に自動で通知される。申請と承認とレビューは人、作業と通知は AI という分担だ。若菜氏によると、利用者も AI に内容を聞きながら、安全にデータを使えるようになった。
ヘッドレス BI の試行と、ナレッジグラフを後回しにした理由
3つ目のテーマは運用とこれからだ。新しい取り組みとして、同社は Looker と並べて、もう一つのセルフサーブの BI を試している。セマンティックレイヤーの Cube を Cloud Run で動かし、IAP で認証する。指標の定義は Cube に一元化し、ロールごとに取得できるデータを制御する。BigQuery のポリシータグも効くため、若菜氏は「これまでの資産がそのまま生きた形でデータを利用できるようになった」と述べた。
画面と切り離した「ヘッドレス BI」なので、出口は自由だ。スプレッドシートでも、Claude の Artifacts でも、Slack からの呼び出しでもよい。ダッシュボードは、定義済みの指標を使って AI が書く。若菜氏が「すごく良かった」と挙げたのは、事業部が自分で画面を作ってくるようになったことだ。Cube の定義は共通の Skill で整備でき、どのプロダクトでも作り方は基本的に同じになるため、データ基盤チームはレビューで支えればよい。Looker も開発チームが LookML を整える形で現場に任せており、同社は2つの形を比べながら、現場に合うセルフサーブを見極めているという。
一方、ナレッジグラフは採用していない。同社は今の使い方で、YAML とナレッジグラフに同じ質問をエージェントに解かせ、回答を採点して比べた。
| 比べたこと | YAML | ナレッジグラフ |
|---|---|---|
| 正しく答える割合 | 同程度 | 同程度 |
| 応答時間・トークン | 少ない | 増えた |
| 答えられない質問の扱い | よい | 使い方次第 |
※登壇資料のスライド「ナレッジグラフはガードレールを優先して一旦後回しにした」をもとに編集部が整理
若菜氏によると、YAML ベースで作り込むうちに YAML の定義がかなり固まり、それだけでエージェントがよい回答を返すようになっていた。YAML に書く運用も定着しているため、運用コストもあまり上がらない。AI エージェントの不適切な使われ方を防ぐガードレール作りを優先し、ナレッジグラフは後回しにしたという。ただし、当社の事例であり他社とは違う可能性がある、とも断ったうえで、近いうちに検証を再開する考えを示した。
データ基盤チームは「作る」から「見守る」へ
まだ解けていない課題も率直に語られた。1つは、セルフサーブ BI の権限がまだ粗いことだ。セマンティックレイヤーの先のデータはスプレッドシートなどいろいろな場所に散らばるため、ダッシュボード単位や行単位の権限はまだない。全社に広げるにあたり、Looker の個人情報の見せ分けと似た形で、組織や資格の情報をもとに権限を動的に管理する仕組みを進めている。もう1つは、機密度のタグ付けが定義の品質次第であることだ。proto への IA レベルの書き漏れは基盤側の一覧で補っているが、書く側の開発チームの理解が欠かせず、点検を続ける。品質の面では、データオブザーバビリティの強化も進めている。
これからの方向性として、若菜氏は、データ基盤の仕事を段階的に利用者へ渡していく道筋を示した。担当者任せの段階1、Slack の窓口で受け付けて基盤チームが作業する段階2を経て、いまは Skill に沿って利用者が進め、基盤チームがレビューする段階3が中心だ。めざすのは、コードで管理し、検査と検知が見守る段階4の「自分で完結」する姿である。そのために、AI がデータを読む道を一本に絞る「入り口」、本番に反映する前に自動で検査する「関門」、反映後の異常に自動で気づく「検知」、普段は機密データに届かない権限にする「土台」を整える。ただし、すべてを任せきりにはしない。機密データの扱いなど、基盤チームが関わり続ける仕事は残るという。
その「入り口」にあたるのが、AI のデータアクセスを Gateway/MCP にまとめる構想だ。いまは Skill、hook、権限の設定が各所に分かれている。これを1つの入り口にまとめ、依頼した本人の権限を超えない、機密度の高い列・行は渡さない、リージョンをまたがない、誰の AI が何を取ったかを記録する、といった同じルールを一貫して効かせる。スライドでは「開発・検証中」とされ、若菜氏は12月ごろの完成を見込んでいると話した。
今日お話しした統制は、そのまま土台として残り、データ基盤を守り続けると思います。Gateway や MCP をこれから作り込んで、データ基盤が見守る立場で動けるような取り組みを進めていく予定です。
最後に若菜氏は、セッションの内容を「Agent Skill で現場に渡す」「権限とネットワークの構造で守る」「定型作業は AI、承認と監視は人」の3つにまとめた。LegalOn で7年ほどデータ基盤チームを運営してきたという若菜氏は、セルフサーブとガバナンスの両立は「かなり課題に感じて作り込んできた」と振り返った。
登壇者
データセクション Head of Data
開催概要
| イベント | Data & AI Summit '26 Fall(主催:Google Cloud) |
|---|---|
| 開催日 | 2026年11月18日(水) |
| 会場 | Google 渋谷オフィス+オンライン配信 |
| セッション | 【Track 2】AI エージェントを活用したセルフサーブのデータ基盤の運用 |
| 登壇 | 若菜 勇気氏(株式会社LegalOn Technologies データセクション Head of Data) |
出典:Data & AI Summit '26 Fall 公式ページ
References
- LegalOn Technologies「現場に渡し、構造で守る AI エージェントを活用したセルフサーブのデータ基盤の運用」(Speaker Deck、登壇資料). https://speakerdeck.com/legalontechnologies/data-ai-summit-26-fall-ai-agent-selfserve(参照 2026-11-19)
- LegalOn Technologies「構造で守らせる データ・法務・セキュリティ・開発チームとつくる AI時代のデータガバナンスとデータ基盤のリアル」(Speaker Deck). https://speakerdeck.com/legalontechnologies/ai-data-governance-real(参照 2026-11-19)
- Google Cloud「Introduction to column-level access control」(BigQuery ドキュメント). https://cloud.google.com/bigquery/docs/column-level-security-intro(参照 2026-11-19)
- Google Cloud「Overview of VPC Service Controls」. https://cloud.google.com/vpc-service-controls/docs/overview(参照 2026-11-19)
Data & AI Summit '26 Fall のほかのレポート
- 【総括】AI エージェントに任せる前に、データに「意味」を Google Cloud と登壇10社が示したデータ基盤の条件
- 【基調講演】AIエージェントは「信頼」と「コスト」で選ばれる、Google Cloud・KDDI・MBKデジタルが示すデータ基盤の条件
- 【Track 1】AIエージェントは「初日の新入社員」 Google Cloud 山田氏が説く、データを動かさない「SOAP」アーキテクチャとコンテキスト運用
- 【Track 1】キリンビール営業部門、商談の質問に AI でその場で回答 BigQuery と Looker で約12週間で本番へ
- 【Track 1】三菱ケミカルが M365・AWS・ServiceNow を Google Cloud でつなぎ、ヘルプデスクを自律化
- 【Track 1】Google Cloud が示すエージェントのデータ基盤、BigQuery と Knowledge Catalog の役割
- 【Track 2】メルカリが dbt platform へ移行、AI エージェントでデータ基盤の運用を自律化
- 【Track 2】G-gen が検証、BigQuery に表と列の説明と業務用語を書くと AI の正答率は17%から100%に
- 【Track 3】Google Cloud が解説、BigQuery と Iceberg の使い分け 4つのテーブル形式と3つの連携パターン
- 【Track 3】ダイニーが AI エージェントを社内向けと社外向けで設計し分ける理由、誤答の影響で「LLM に任せる範囲」を決める
- 【Track 3】Google Cloud が語る「見る BI」の先 Looker で AI と会話し、作らせ、エージェントから使う
- 【Track 3】Google Cloud が提言、AI エージェントから本番 DB を守る「サービング DB」と3つの設計要件
- 【Track 3】MIXI が Looker の会話分析をサブエージェントに、アナリストが自ら育てる「モンスト」の社内分析 AI
本イベントのほかのレポートも公開しています
この記事では Track 2 の LegalOn Technologies のセッションを取り上げました。ほかの12本のレポートは、上の一覧からご覧いただけます。(trends. 編集部)















What's New
新着記事

Googleが社内のデータシミュレーターの仕組みを紹介、短い説明から架空企業のデータと検証済みの正解の生成が可能

アストリス・アドバイザリー・ジャパン株式会社が株式 会社ジェイテックコーポレーション(証券コード:3446)に関する2027年3月期1Q決算アップデートレポートを発行

1月13日(水) AndTech「広視野・高精細化・小型軽量化を実現するXR・AR用ヘッドマウン トディスプレイの光学設計とレーザ網膜投影技術」Zoomセミナーを開講予定

1月13日(水) AndTech「光電融合・CPO向け光コネクタ・光導波路の開発と周辺材料への 要求特性・信頼性評価」Zoomセミナーを開講予定

