


Google Cloud が語る「見る BI」の先 Looker で AI と会話し、作らせ、エージェントから使う
公開:
BI ツールのゴールは、きれいなダッシュボードを作ることではなくなりつつある。AI と会話し、AI に作らせ、ほかのエージェントから呼び出す時代に、BI ツールには何が求められるのか。
Google Cloud の「Data & AI Summit '26 Fall」で、Google Cloud の赤栗雅史氏が、BI の領域で起きている3つのシフトと、それを支える Looker の仕組みを解説した。データの定義を決めておく「セマンティックレイヤー」が数字のぶれをどう防ぐのか。資料を渡すだけでデータ定義とダッシュボードを AI に作らせるデモ、新機能「Looker Data Apps」、Gemini から Looker のデータエージェントを呼び出すデモまで、その中身を紹介する。
この記事の要点
- BI では「会話する」「作るから作らせる」「エージェントから使う」の3つのシフトが起きている。土台になるのは、データの定義(セマンティックレイヤー)、すべてをコードで扱えること、外部から呼び出せる仕組みの3つだと赤栗氏は述べた
- 生成 AI が書く SQL には推論が入り、同じ質問でも数字がぶれることがある。集計ロジックを事前に定義しておけば、Looker は SQL を決定論的に生成でき、数字の正しさを担保できる
- Looker を使っていなくても、AI に作らせれば1か月で3つのシフトを体験できる。スライドでは、既存 BI の定義をもとに AI にセマンティックレイヤーとダッシュボードを作らせ、対象を3〜5本に絞って既存と同じ数字が出るかを突き合わせるところから始める進め方が示された
目次
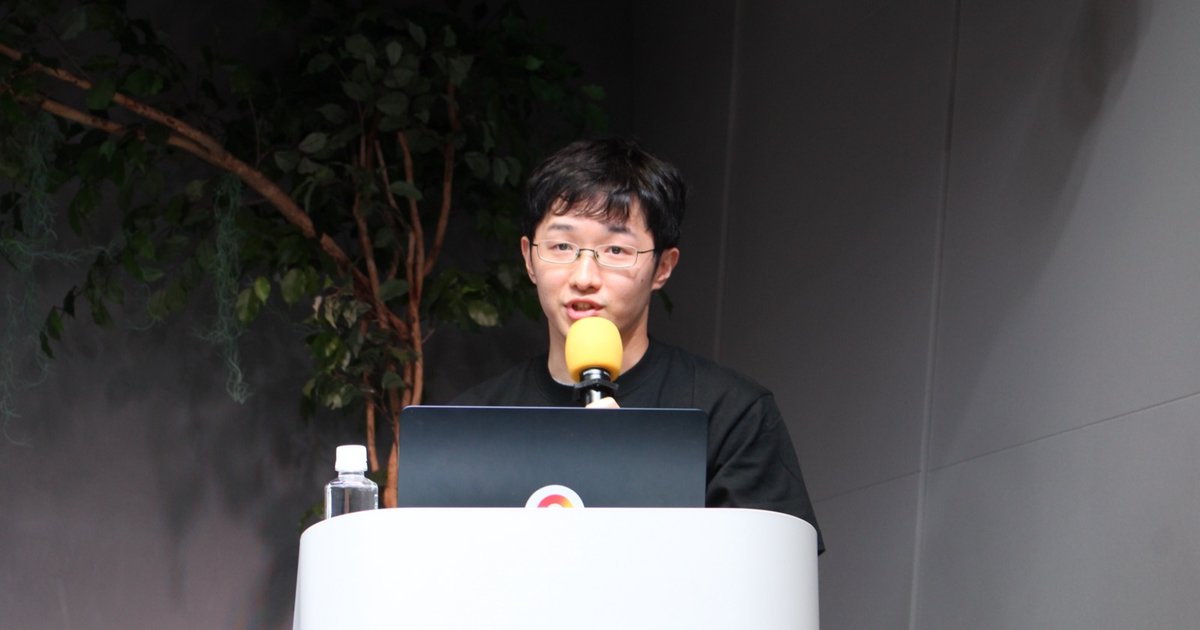
Google Cloud は2026年11月18日、データと AI をテーマにしたイベント「Data & AI Summit '26 Fall」を Google 渋谷オフィスとオンラインで開いた。Track 3 の16時25分からのブレイクアウトセッション「「見る BI」の先へ ー Looker と AI エージェントが変革するデータ活用の未来」には、Google Cloud の Cloud BI Sales Specialist、赤栗雅史氏が登壇した。主に Looker の営業を担当し、入社前から BI ツールの会社で働いてきた赤栗氏は、「かれこれ10年ぐらい BI ツールに関わっているが、特にここ半年、1年ぐらいは、BI ツールの領域でも生成 AI やエージェントで変化が大きく起こっている」と話し始めた。
なお、このセッションは終盤の数分しか撮影できなかったため、それより前のスライドやデモの画面は掲載していない。記事の大半は、会場で録音した音声をもとにまとめた。

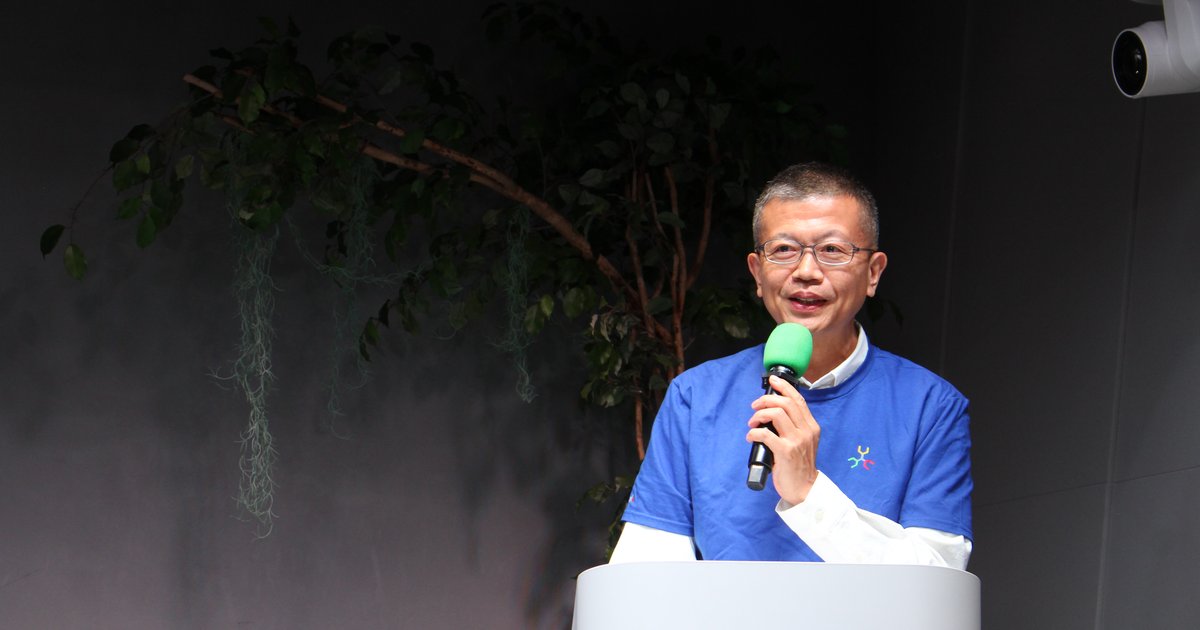
Google Cloud Cloud BI Sales Specialist の赤栗雅史氏
BI に起きている3つのシフト
赤栗氏はまず、生成 AI がもたらした変化を3つ挙げた。生成 AI が言葉を理解するようになったこと。コードを書くことが生成 AI の得意分野になり、エンジニアも一行ずつ書くより AI を使っていかに効率よく開発するかに変わってきたこと。そして、人がツールを使うのではなく、エージェントや生成 AI が直接ツールを使ったり操作したりできるようになったことだ。赤栗氏によると、この3つが BI ツールにもそれぞれ大きなシフトを起こしている。
| シフト | これまで | これから | 求められるもの |
|---|---|---|---|
| ① 会話する | ダッシュボードを作ることがゴール | ダッシュボードがある前提で、AI と自然言語で会話してデータを深掘りし、インサイトやサマリーを引き出す | データの定義(セマンティックレイヤー) |
| ② 作るから作らせる | 使いやすい UI とドラッグ&ドロップで、誰でも簡単にダッシュボードを作れること | エージェントや生成 AI に自然言語で指示して、チャートやダッシュボードを作らせる | すべての操作をコードで管理・構築できること |
| ③ エージェントから使う | BI ツールにログインしてダッシュボードを見に行く | 各種エージェントから、必要なときに BI ツールやダッシュボードにアクセスして使う | 外部のエージェントやツールから呼び出せる仕組み |
※赤栗氏の説明をもとに編集部が整理(この部分のスライドは撮影していない)
一方で、変わらず重要なものもある。データを見せる相手を絞る権限の制御、誰がデータを見てどう操作したかを追える監査のログ、そして利用者が増え、エージェントが頻繁にアクセスするようになっても安定して動く基盤だ。赤栗氏は、セキュリティのインシデントや情報漏洩の話が毎日のように出てくる現状に触れ、「人であれば人数や使い方をある程度想定できるが、エージェントになると、誰が何をどう見たかを管理・監査するのが難しい時代になる」と指摘した。新しいエージェントの仕組みを使いつつ、それを安定して安全に使えることも BI ツールに求められるという。
土台は、Looker がもともと持っていた3つの特徴
赤栗氏によると、この3つの土台を示したスライドは、新しく作ったものではない。もともと Looker のセールス資料にあった構成に、コメントを書き足しただけだという。セマンティックレイヤー、すべてをコードで管理できる「BI as Code」、そして API で何でもできること。この3つは、Looker がほかの BI ツールと比べて差別化のポイントにしてきた特徴だった。MCP という言葉自体は最近のものだが、Looker はもともと API で何でもできた、と赤栗氏は述べ、マネージドの MCP のような最近の機能も、このベースの上で生きていると説明した。
「9割正しい」エージェントは使われない
赤栗氏が特に時間を割いたのが、セマンティックレイヤーだ。正しい数字をいつも取ってこないエージェントは、どんどん使われなくなる。「9割ぐらいは正しい」というエージェントが現場でメインに使われるかというと、数字を信頼できないものを業務で使い続けるのは難しい、と赤栗氏は言う。
数字がぶれる理由は、生成 AI のデータの取り方にある。生成 AI は最終的にデータベースに SQL を書いてデータを取ってくるが、そこには推論が入る。可能性の高い SQL を書くので、それらしいデータは取ってこられる。しかし、同じ質問を100回したときに100回同じ答えが返るかは確率の話になる。シンプルな質問なら90数%になるかもしれないが、複雑になるほど数字がぶれる可能性は上がっていく。
セマンティックレイヤーは、これを別のアプローチで解く。売上のような一般的な集計ロジックを事前に定義しておけば、Looker の仕組みで、推論ではなく決定論的に SQL を生成できる。AI が「売上」を選んだ場合は、決められた取り方と集計ロジックで数字を取ってくるので、その部分の正しさは担保される。
AI に SQL を一から推論させると、同じ質問でも数字が変わり得る。指標の計算方法を先にセマンティックレイヤーで定義しておけば、AI がその指標を選んだときの数字は毎回同じになる。会話で分析する時代ほど、この「定義」が土台になる。
シフト①:AI と会話してデータを深掘りする
Looker の会話分析(Conversational Analytics)は、すでに一般提供されている[1]。赤栗氏は、リリースから1年以上がたち、Gemini 3 の登場以降はモデル自体が賢くなったことで、欲しいデータを自然言語で聞いて取ってくる、取ってきたデータからインサイトを得てアクションを提案させる、といった操作が「本当に精度高くできるようになっている」と述べた。
赤栗氏によると、Looker の会話分析は、モデルをそのまま使うのではなく、分析に特化した推論や、曖昧な質問が来たときに確認する仕組みなどを組み込んでいる。そのため、データさえ準備すれば、低いハードルですぐに使い始められるという。
ダッシュボードにも生成 AI の機能が組み込まれている。権限を与えられたユーザーは、ダッシュボードの画面で Gemini のボタンを押せば、画面の右側でダッシュボードの要約をさせたり、そこから深掘りの分析をしたりできる。赤栗氏は、カスタムで開発することもできるが、組み込みの機能として用意されているので、ダッシュボードさえあれば追加の開発なしにすぐ使えると説明した。Looker のリリースノートによると、ダッシュボード上のデータエージェントは2026年10月に一般提供になっている[2]。
シフト②:ダッシュボードは「作る」から「作らせる」へ
赤栗氏が「この半年ぐらいで一番進化し、マーケットとしても変わってきている」と話したのが、2つ目のシフトだ。去年であれば、生成 AI に簡単な依頼をしても、人が期待する見た目のダッシュボードはまったく作れなかった。それがここ半年ほどで、簡単な指示で期待以上のダッシュボードを作ったり、渡したインプットを再現したダッシュボードを作ったりできるようになったという。
赤栗氏は、BI ツールを大規模に導入すると、これまでは見るだけの「ビューアー」が多かったと指摘する。AI に作らせる仕組みが社内で使われるようになれば、ツールの操作を覚えなくても、誰もが自然言語の指示だけで欲しいレポートを作り、チームに共有できる。スキルがない人でも簡単にレポートを作れる時代が、特に来年に大きく進むと見ている。
作るだけでなく、改善もエージェントに任せられるようになっている、と赤栗氏は続けた。データの定義や会話分析に必要な情報は、使うほど増え、手を入れ続けないと精度が落ちていく。これまでは何人ものエンジニアが更新を続ける必要があった。赤栗氏によると、利用のログや、ユーザーによる回答の良しあしの評価をもとに、生成 AI が必要な指標や同義語の設定を提案し、修正のコードまで書く。人はそれを承認するだけで本番に反映され、改善のループを定期的に回せるという。
デモ:資料を渡すだけで、データ定義からダッシュボードまで
続いて、架空の EC 企業のマーケティング部長から依頼を受けた、という設定のデモが紹介された。一行もコードを書かず、ダッシュボードの構築もせずに、データの定義からダッシュボード、そこからの示唆までたどり着く流れだ。デモの画面は撮影していないため、画像は掲載していない。
- 開発画面で、事前に用意したテーブルの定義書と分析要件を読み込ませ、「セマンティックレイヤーを作って」と指示する。「分析要件にある定義を守って」「同義語も設定して」と追加で指示すると、数分で5、6ファイルほどのデータ定義のコードが生成された
- 正解のデータをいくつか与え、できた定義で集計した数字が正しいかを、生成 AI にチェックさせる
- ホワイトボードに描いた完成イメージの画像を渡して「こんな感じでサンプルのダッシュボードを作って」と指示すると、ダッシュボードのコードが生成され、Looker 上でそのままダッシュボードとして表示できた
- できたダッシュボードに対して、ダッシュボードのエージェントでインサイトを出させる
赤栗氏は、セマンティックレイヤーはこれまで人が書く必要があり、作れる会社はかなり少なかったと振り返った。今は自然言語で指示するだけでできるため、データの準備さえあれば、構築のハードルはかなり下がったという。生成されたダッシュボードも、裏側はすべてコードだが、書き方を覚える必要はない。デモでは一部をカットしていたが、実際にも10分ほどでここまでたどり着けると説明した。
新機能「Looker Data Apps」
赤栗氏は、最近出た新機能として「Looker Data Apps」も紹介した。先ほどのデモで作ったのは Looker のダッシュボードだが、生成 AI を使えば、Looker のダッシュボードの形に縛られない、Web ページのようなレポートも簡単に作れる。Looker Data Apps は、そうした自由な見た目のレポートを、Looker 上でダッシュボードとして使えるようにする仕組みだ。公式ドキュメントでは、Gemini CLI や Claude Code などのローカルの AI コーディングエージェントが、自然言語の指示から生成する自由なキャンバスのダッシュボードと説明されている。現時点ではプレビューとして提供されている[3][4]。
赤栗氏は、リッチな見た目のレポートを作ること自体は生成 AI がとても得意だとしたうえで、課題を挙げた。その数字は正しいデータから取れているのか。共有するときの権限はどう制御するのか。ホストする環境は安全なのか。こうした点は、HTML を AI に作らせるだけでは担保できない。Looker がもともと持つセマンティックレイヤーと権限制御の仕組みを Data Apps で使えば、そこを担保できるという。
シフト③:BI ツールはエージェントから使うものに
3つ目のシフトについて、赤栗氏は、BI ツールをそのまま使うことはもちろんできるが、今後の業務ではエージェントから使う場面がかなり増えると述べた。Google のサービスでいえば Gemini(Looker との連携先としての正式名は Gemini Enterprise)、さらに Antigravity のようなコーディングエージェントもそうだ。開発者が使うコーディングエージェントや、エンドユーザーが使うエージェントのツールから、直接 Looker の情報を使ってダッシュボードを作ったり分析したりすることが、どんどん増えていくという。
Looker からの方法は2つある。1つは、Looker で作ったデータエージェントを Gemini Enterprise に公開し、そこから呼び出す方法だ。赤栗氏によると、公開はボタン一つでできる。Looker のドキュメントでは、Gemini Enterprise との連携はプレビューと記載されている[5]。もう1つは、Looker のマネージドの MCP サーバーを使う方法で、外部のエージェントから Looker にクエリを実行したり、ダッシュボードを作ったりできる。このマネージドの MCP サーバーは、2026年10月に一般提供になった[6]。
エージェントから使う利点について、赤栗氏はビジネスユーザーの業務を例に挙げた。業務ではデータだけでなく、PowerPoint やドキュメントの資料、人によっては社外の Web の情報も使う。そのたびにデータ分析のツールや別のエージェントのツールを行き来するのではなく、そのハブになるのが今後のエージェントのサービスだという。
デモ:売上のデータと社内の報告書を、1つの画面で
デモでは、Gemini の画面で「@」を使い、Looker で作った売上と返品を分析するデータエージェントを呼び出した。デモの画面は撮影していないため、画像は掲載していない。
「今月、計画が未達で達成率が悪い商品カテゴリーはどこ?」と聞くと、データエージェントが Looker のデータを分析し、アウターの達成率と返品率が悪いことを示した。そこから、今度はデータではなく社内のドキュメントを対象に、月次の報告書が上がっていないか、対応策を考えて、と続けると、サイズ表記と実寸の乖離が返品の理由だったことを報告資料から読み取り、対策案まで考えた。データの分析と社内文書の調査を、1つの画面の中で続けて行えることを示すデモだった。
いろいろな情報を使って業務を行うときに、いちいちデータ分析ツールに行って、いちいち別のエージェントツールに行って、というような、そこにハブになっていくのが、今後こういったエージェントのサービスになるんじゃないかと思います。
まず、何から始めるか
最後に赤栗氏は、3つのシフトを支えるセマンティックレイヤー、コードによる管理、外部から呼び出せる仕組みが、今後ますます重要になるとまとめた。BI ツールを今もダッシュボードとして使っている人はかなり多いと思うが、データさえあれば、これらは簡単に試せるという。
赤栗氏によると、Looker のトライアルには、これまで3か月ほどかけるケースもあった。今は生成 AI に全部作らせられるので、1か月あれば、データの定義とダッシュボードを自動で生成し、会話分析や、エージェントを業務でどう使えるかまで試せる。エンジニアをアサインする必要もないという。スライドでは、その進め方が2つのステップで示された。
Step 1 AI にクイックに作らせる(シフト②)
既存 BI の定義をエクスポートし、AI にセマンティックレイヤーとダッシュボードを生成させる。対象は3〜5本。既存と同じ数字が出るかを突き合わせる。ゼロから作らない。
Step 2 会話する・エージェントから使う(シフト①・③)
作ったダッシュボードで会話分析とダッシュボードのエージェントを試す。エージェントを Gemini に公開し、1部門のビジネスユーザーで試す。答えられない質問は定義に追加する。権限と監査はそのまま効く。
※スライド「まず、何から始めるか」をもとに編集部が整理

入口は「AI に作らせる」。Looker を使っていなくても、1か月で3つのシフトを体験できるという
赤栗氏は「ぜひこの新しい BI のシフトを、Looker を使って体験していただければ」と呼びかけ、セッションを締めくくった。
登壇者
Cloud BI Sales Specialist
開催概要
| イベント | Data & AI Summit '26 Fall(主催:Google Cloud) |
|---|---|
| 開催日 | 2026年11月18日(水) |
| 会場 | Google 渋谷オフィス+オンライン配信 |
| セッション | 【Track 3】「見る BI」の先へ ー Looker と AI エージェントが変革するデータ活用の未来 |
| 登壇 | 赤栗雅史氏(Google Cloud Cloud BI Sales Specialist) |
出典:Data & AI Summit '26 Fall 公式ページ
References
- Google Cloud ブログ「Welcome to the agentic BI era with Looker」(2026年4月23日). https://cloud.google.com/blog/products/business-intelligence/looker-updates-for-agentic-bi-at-next26(参照 2026-11-19)
- Looker リリースノート(2026年10月8日の項:ダッシュボードのデータエージェントの一般提供). https://docs.cloud.google.com/looker/docs/release-notes(参照 2026-11-19)
- Looker ドキュメント「Looker Data Apps overview and setup」. https://docs.cloud.google.com/looker/docs/data-apps(参照 2026-11-19)
- Google Cloud ブログ「Looker を活用した Agentic Data Cloud 向けの信頼できるデータアプリ」(2026年10月19日、米国時間10月13日の記事の抄訳). https://cloud.google.com/blog/ja/products/business-intelligence/introducing-looker-data-apps(参照 2026-11-19)
- Looker ドキュメント「Conversational Analytics の Explore データエージェント」(「Publish a data agent」の項). https://docs.cloud.google.com/looker/docs/conversational-analytics-looker-data-agents(参照 2026-11-19)
- Looker リリースノート(2026年10月26日の項:Looker-managed MCP server の一般提供). https://docs.cloud.google.com/looker/docs/release-notes(参照 2026-11-19)
Data & AI Summit '26 Fall のほかのレポート
- 【総括】AI エージェントに任せる前に、データに「意味」を Google Cloud と登壇10社が示したデータ基盤の条件
- 【基調講演】AIエージェントは「信頼」と「コスト」で選ばれる、Google Cloud・KDDI・MBKデジタルが示すデータ基盤の条件
- 【Track 1】AIエージェントは「初日の新入社員」 Google Cloud 山田氏が説く、データを動かさない「SOAP」アーキテクチャとコンテキスト運用
- 【Track 1】キリンビール営業部門、商談の質問に AI でその場で回答 BigQuery と Looker で約12週間で本番へ
- 【Track 1】三菱ケミカルが M365・AWS・ServiceNow を Google Cloud でつなぎ、ヘルプデスクを自律化
- 【Track 1】Google Cloud が示すエージェントのデータ基盤、BigQuery と Knowledge Catalog の役割
- 【Track 2】メルカリが dbt platform へ移行、AI エージェントでデータ基盤の運用を自律化
- 【Track 2】G-gen が検証、BigQuery に表と列の説明と業務用語を書くと AI の正答率は17%から100%に
- 【Track 2】LegalOn Technologies、Agent Skill で現場にデータ基盤を渡し「構造」で守る運用
- 【Track 3】Google Cloud が解説、BigQuery と Iceberg の使い分け 4つのテーブル形式と3つの連携パターン
- 【Track 3】ダイニーが AI エージェントを社内向けと社外向けで設計し分ける理由、誤答の影響で「LLM に任せる範囲」を決める
- 【Track 3】Google Cloud が提言、AI エージェントから本番 DB を守る「サービング DB」と3つの設計要件
- 【Track 3】MIXI が Looker の会話分析をサブエージェントに、アナリストが自ら育てる「モンスト」の社内分析 AI
本イベントのほかのレポートも公開しています
この記事では Track 3 の Google Cloud による Looker のセッションを取り上げました。ほかの12本のレポートは、上の一覧からご覧いただけます。(trends. 編集部)















What's New
新着記事

Googleが社内のデータシミュレーターの仕組みを紹介、短い説明から架空企業のデータと検証済みの正解の生成が可能

アストリス・アドバイザリー・ジャパン株式会社が株式 会社ジェイテックコーポレーション(証券コード:3446)に関する2027年3月期1Q決算アップデートレポートを発行

1月13日(水) AndTech「広視野・高精細化・小型軽量化を実現するXR・AR用ヘッドマウン トディスプレイの光学設計とレーザ網膜投影技術」Zoomセミナーを開講予定

1月13日(水) AndTech「光電融合・CPO向け光コネクタ・光導波路の開発と周辺材料への 要求特性・信頼性評価」Zoomセミナーを開講予定

