


G-gen が検証、BigQuery に表と列の説明と業務用語を書くと AI の正答率は17%から100%に
公開:
AI に売上を聞いたら、手元の数字と合わない。その原因は、AI のモデルよりもデータ基盤の側にあるのかもしれない。
Google Cloud の「Data & AI Summit '26 Fall」で、G-gen の河野 利紀氏が、AI が正しく読める BigQuery の設計を解説した。同じ架空の売上データに、何も説明しないエージェント、表と列の説明を加えたエージェント、さらに業務用語を登録したエージェントの3つを用意して比べたところ、正答率は17%から100%に上がったという。人の頭の中にある「決め事」をデータ基盤に書き込む手順を紹介する。
この記事の要点
- AI がデータウェアハウスを読み間違える原因は、表や列の説明がない、決め事が担当者の頭の中にある、部署ごとに定義がバラバラ、の3つ。AI はその空白を推測で埋め、もっともらしい答えを返す
- G-gen の検証では、同じデータ・同じ質問でも、表と列の説明に加えて業務用語を8語登録したデータエージェントは、12問すべてに正しく答えた。正答率は17%から100%になった
- 手順は、マートを作る、評価用の質問と正解を用意する、表と列の説明と業務用語を登録する、それでも足りなければ検証済みクエリ・プロファイルスキャン・BigQuery Graph で構造を伝える、の4段階
目次
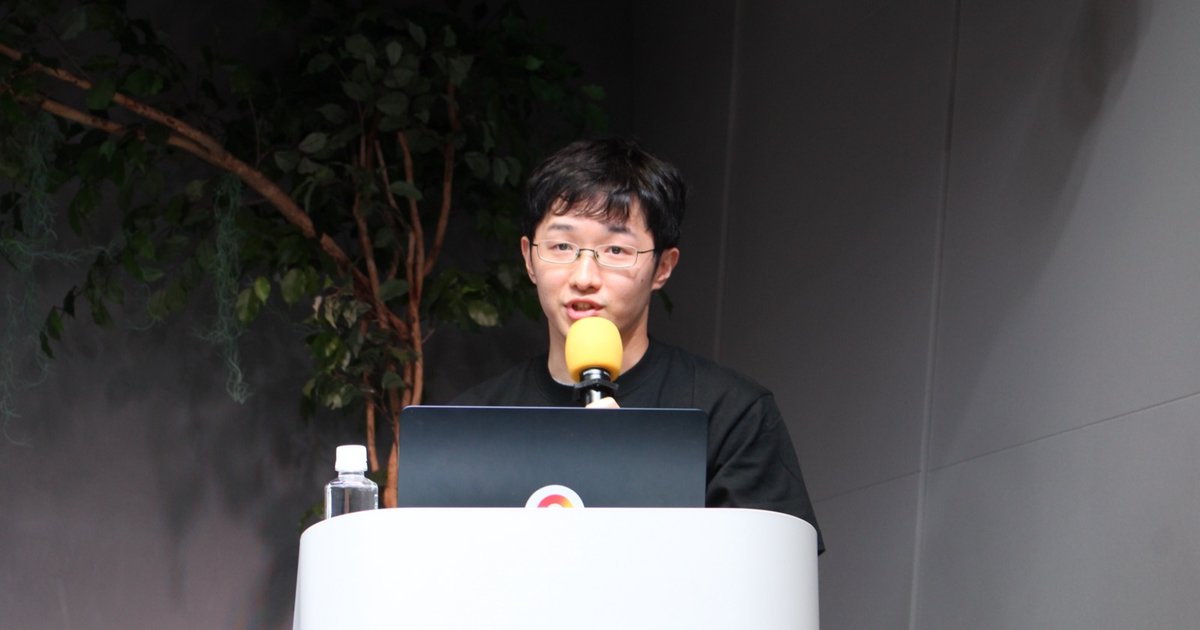
Google Cloud は2026年11月18日、データと AI をテーマにしたイベント「Data & AI Summit '26 Fall」を Google 渋谷オフィスとオンラインで開いた。Track 2 の15時45分からのブレイクアウトセッション「AI が正しく読めるデータ基盤 BigQuery 設計の勘所」には、株式会社G-gen クラウドソリューション部 エンジニアの河野 利紀氏が登壇した。河野氏によると、G-gen は Google Cloud のプレミアパートナーで、Google Cloud を使った課題解決や、顧客が自ら使いこなして内製化するための伴走支援を行っている。河野氏自身は、生成 AI の活用やエージェント開発に取り組み、Gemini や BigQuery を扱う案件に参画しているという。
なお、取材では講演の終盤(プロファイルスキャンの解説以降)しか撮影できていない。それより前の内容は音声をもとに書いており、スライドの画像は掲載していない。

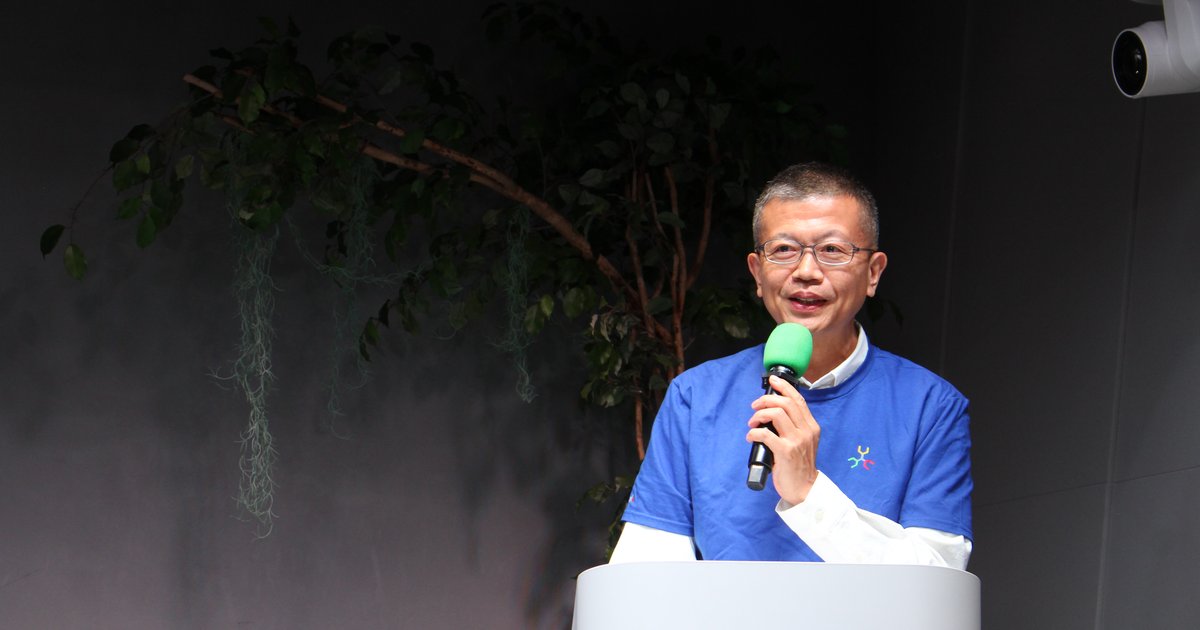
株式会社G-gen クラウドソリューション部 エンジニアの河野 利紀氏
AI が返した数字を、そのまま信じてよいか
河野氏は、AI とデータウェアハウスをつないだ人が一度は経験しそうな場面から話を始めた。AI にあるテーブルの売上金額を聞いてみたが、手元の数字と合わない、というものだ。
これまでは、数字が欲しければ分析担当者に SQL を書いてもらい、数日後に答えが返ってくるのが普通だった。今は誰でも自然言語で質問するだけで、AI が SQL を作り、すぐに数字を返してくれる。大きな工数の削減につながる一方で、河野氏は「AI が返したその数字をそのまま信じてよいのか」と問いかけた。ちょっとした調べ物ならおおよその値で構わないが、経営会議の資料、予算の策定、顧客への報告など、数字をもとに判断する場面では、そのまま信じるわけにはいかない。
では、なぜ AI は間違えるのか。河野氏は、AI がデータウェアハウスを読み間違える典型的なポイントを3つ挙げた。
① 表や列の説明がない
どういうテーブル・列なのかの説明がない。「削除フラグ」を略したような列名など、AI が読み解きにくい。
② 決め事が外にある
「東日本エリアに新潟を含めるか」のようなルールが、担当者の頭の中の暗黙知になっている。
③ 定義がバラバラ
「既存店に閉店した店を含めるか」のようなルールが、部署ごとに違う。
※河野氏の説明をもとに編集部が整理
こうしたことは AI には分からない。河野氏によると、AI は空白を推測で埋めて、もっともらしい答えを返してくる。後で紹介する検証でも、架空の売上データに「2025年度の売上はいくら?」と聞いたとき、何も渡さない場合、列の意味を渡した場合、業務の決め事を渡した場合で、答えがまったく変わったという。質問もデータもモデルも同じで、違うのは渡した意味の補足情報だけだ。
対策について、河野氏は「答えはシンプル」だとし、人の頭の中にある決め事を洗い出して、データ基盤に落とし込むことを挙げた。列の意味や業務用語の意味を、データ基盤の側に書いておくということだ。
意味を置く場所として BigQuery を選ぶ理由
その「意味」を置く場所として、河野氏は BigQuery が最適だとし、理由を3つ挙げた。
1つ目は、意味をデータのすぐ隣に置けること。専用のカラムやテーブルを用意しなくても、BigQuery の標準の機能で、テーブルや列に説明を書いたり、業務用語集を作ってテーブルにひも付けたりできる。2つ目は、BigQuery でデータエージェントが標準で使えること。BigQuery のテーブルをソースに、ノーコードで誰でも作れる。3つ目は、AI を経由しても見える範囲が変わらないこと。河野氏によると、データエージェントは実行する人の IAM 権限でデータを読むため、見えてはいけないものが見えることはなく、権限管理を見直す手間もかからない[1]。
河野氏は、データ基盤を「人が見る保管庫」から「エージェントが使う基盤」へ変えていく考え方を、いわゆる「Agentic Data Cloud」として紹介し、それに適しているのが BigQuery だと述べた。
この講演で主役になるのが、BigQuery のデータエージェントだ。「2025年度の売上は?」と自然言語で質問すると、データエージェントが SQL を作って実行し、答えを返す。河野氏によると、データエージェントは SQL を生成する前に、まず基盤にある「意味」を読む。だから答えの質は、BigQuery にどれだけ意味が書き込まれているかで変わる。
意味として置けるものは、大きく3つあるという。表や列の説明(スキーマの説明)。社内独自の言い回しや業務用語を「この言葉はこういう意味」と登録する用語集で、Knowledge Catalog に登録して BigQuery のテーブルにひも付けられる[1]。そして、表のつなぎ方などのデータの構造で、AI が推測しなくても済むように事前に定義しておける。
マートだけを見せ、1エージェント1業務領域に
全体の構成は、データ層、コンテキスト層、そしてエージェントの部分に分けて説明された。BigQuery で生データを整形してマートを作る部分は、これまでと変わらない。河野氏が注目してほしいと述べたのは、その上に重ねるコンテキスト層だ。すでに BigQuery を使っている場合は、ここに意味を追加していく作業が要る。
データ層では、BigQuery にデータが入っていなければ取り込みから始める。河野氏は、Datastream を使えば他社クラウドやオンプレミスの MySQL、PostgreSQL のデータを、Data Transfer Service を使えば YouTube や Google 広告、Salesforce などの SaaS のデータを取り込めると紹介した。取り込んだデータを集計・結合して必要なものだけを取り出し、マートにする。
データエージェントには、生データの全量ではなく、必要な情報を取り出したマートだけを見せる。河野氏によると、データが多いと AI が迷いやすくなって精度が落ちるだけでなく、生成の負荷やトークンの消費も大きくなる。
エージェント層にも注意点がある。データエージェントは、ソースのテーブルを指定し、動作の指示文を書けば作れる。河野氏は「Gemini の Gem やノーコードのエージェントと同じような作り方」と説明した。ただし、あらゆるテーブルをソースにつないで「質問が来たら数値と根拠を返す」といった守備範囲の広いエージェントを作るより、売上分析用、マーケティング用のように「1エージェント1業務領域」で分けるほうがよいという。ソースが多いと、どのテーブルを使えばよいかで AI が迷う。河野氏は「迷う材料を減らせば減らすほど、エージェントの答えは安定する」と述べた。
検証:説明と用語集で正答率は17%から100%に
ここまでの設計の考え方を確かめるため、河野氏は実際に BigQuery でデータエージェントを作り、回答の精度を比べた。データはすべて同じ架空の売上データで、条件の違う3つのエージェントを用意した。
| エージェント | 設定した内容 | 結果(河野氏の説明) |
|---|---|---|
| A | 説明なし。ありのままのテーブル | ちょくちょく間違えた |
| B | A に、表と列の説明を追加 | 少し上がったが、分からない部分が残った |
| C | B に、業務用語を8語追加 | すべての質問に正しく答えた |
※河野氏の説明(音声)をもとに編集部が整理。質問は6問を2回ずつ、計12問。この部分のスライドは撮影していない
データエージェントは、BigQuery のサイドメニューにある「エージェント」から作れる。「ナレッジソース」に元のテーブルやビューを指定し、「手順」にエージェントの動作を書く。今回は、質問に対して答えの数値を返すだけのエージェントを3つ作ったという。
B と C には列の説明を加えた。たとえば「CH」という列は、あえて分かりにくい名前にしてあり、説明に「販売チャネル。01は店舗、02は EC」と書いた。テーブルにも、どういうテーブルなのかの説明を書いた。C にはさらに、エージェントの作成画面で直接、用語集を登録した。中身は、「売上」は税抜きを指す、返品と取り消しの行は除く、年度は4月始まり、といった社内のルールだ。用語集は Knowledge Catalog に登録してテーブルにひも付けることもできるが、今回はエージェントに直接登録したという。
結果は、A がたびたび間違え、B は少し改善したものの分からない部分が残り、C はすべての質問に正しく答えた。河野氏によると、正答率は17%から100%まで上がった。担当者が持っていた暗黙知を、表と列の説明、用語集として落とし込んだことで、AI が正しい答えを返すようになったという。
同じ質問で、データも同じで、モデルも同じなんですけど、違いは渡した意味の補足情報によって、全然結果が変わってくるというものになります。
意味を設定する効果は、精度だけではないという。河野氏によると、回答の文章が2割ほど短くなり、応答時間も16%ほど短くなった。定義がはっきりしているので、エージェントが迷わず、求められた答えだけを返すからだ。河野氏は、データ基盤に意味を落とし込むことは「トークンや待ち時間の節約にもつながる」と述べた。
あわせて、データエージェントの画面も紹介された。Gemini のチャット画面のように、自然言語で質問するとテキストで値を返す。河野氏によると、「売上の推移を棒グラフで」「表で」と頼めばグラフや表も出せ、CSV や PDF にも出力できる。「思考プロセスを表示」を使えば、エージェントが読んだ文脈や実行した SQL を確認でき、SQL のレベルで答え合わせができるという[1]。
AI に読ませるための4つのステップ
最後に河野氏は、既存の BigQuery を AI が読めるデータ基盤にしていく手順を4つのステップにまとめた。
- ステップ1:マートを作る BigQuery にデータを取り込み、マートを作る(すでにマートがあれば不要)
- ステップ2:評価を用意する よく聞かれる質問と、その正解を20〜30件ほど用意する
- ステップ3:意味を書く 検証でやったように、表と列の説明、業務用語を登録する
- ステップ4:構造を伝える 表の関係や値の分布などを登録する。ステップ3で精度が上がらなかったときに試す
※河野氏の説明(音声)をもとに編集部が整理
ステップ4は今回の検証では試していない部分で、検証済みクエリ、プロファイルスキャン、BigQuery Graph の3つが紹介された。
検証済みクエリは、よく聞かれる質問に対して、担当者が確かめた SQL を手本として登録しておくものだ[1]。河野氏は「カンニングペーパー的なもの」と表現した。ステップ3の説明や用語集をしっかり書けていれば要らないこともあるが、それでも精度が出ないときに、答えそのものを登録してしまう手段だという。
プロファイルスキャンは、テーブルの各列にどんな値がどのくらいの割合で入っているかを自動で調べ、それを AI に見せられるようにする機能だ。河野氏が挙げた例は「東日本の売上は?」という質問。スキャンがないと、AI は「WHERE area_cd = '東日本'」と推測で書いてしまうことがある。実際には列に「E」と「W」しか入っていなければ、結果はゼロになる。スキャンしておけば、AI は値が「E」と「W」だけだと先に分かり、正しい条件で検索できる。

プロファイルスキャンで、列にどんな値がどの割合で入っているかを AI に先に伝える
BigQuery Graph は、テーブル同士のつながりを定義する機能だ[2]。スライドの例では、店舗・商品・売上のつながりを、点(テーブル)と線(テーブル間の関係)として登録していた。AI が複数のテーブルを結合して SQL を書くとき、どのテーブルとどのテーブルをどうつなげば求める答えが返るのかを示せる。スライドには、設定するとつなぎ方を AI が推測しなくて済み、3つ以上の結合でもつなぎ方を間違えにくいと書かれていた。河野氏は、プロファイルスキャンと同じく、精度が出ないときに試してほしいと述べた。

BigQuery Graph で、店舗・商品・売上のつながりを点と線として登録する
「人が読む」から「AI が読む」データ基盤へ
河野氏は講演を3つのポイントでまとめた。1つ目は、データウェアハウスが「人が見る保管庫」から「エージェントが使うデータ基盤」へ変わること。2つ目は、AI の答えの質はモデルよりデータ基盤で決まること。すでに AI をつないでいる場合も、これから賢いモデルが出ればだんだん良くなるだろうと待つのではなく、まずデータ基盤を見直してほしいという。3つ目は、マートを作り、意味を書いて、評価で確かめること。

まとめのスライド。「人が読む」から「AI が読む」データ基盤へ
すでにきちんと動いているデータウェアハウスに、データそのものとは別の「意味」を書き足す作業は、面倒に思えるかもしれない。それでも河野氏は、意味を加えればデータエージェントが正しく動き、結果的に大きな工数の削減につながるとして、「人が読む」データウェアハウスから「AI が読む」データウェアハウスへ進めてほしいと呼びかけた。
登壇者
クラウドソリューション部 エンジニア
開催概要
| イベント | Data & AI Summit '26 Fall(主催:Google Cloud) |
|---|---|
| 開催日 | 2026年11月18日(水) |
| 会場 | Google 渋谷オフィス+オンライン配信 |
| セッション | 【Track 2】AI が正しく読めるデータ基盤 BigQuery 設計の勘所 |
| 登壇 | 河野 利紀氏(株式会社G-gen クラウドソリューション部 エンジニア) |
出典:Data & AI Summit '26 Fall 公式ページ、株式会社G-gen プレスリリース(2026年11月12日)
References
- Google Cloud「Conversational analytics overview」(BigQuery ドキュメント). https://docs.cloud.google.com/bigquery/docs/conversational-analytics(参照 2026-11-19)
- Google Cloud「Introduction to BigQuery Graph」(BigQuery ドキュメント). https://docs.cloud.google.com/bigquery/docs/graph-overview(参照 2026-11-19)
Data & AI Summit '26 Fall のほかのレポート
- 【総括】AI エージェントに任せる前に、データに「意味」を Google Cloud と登壇10社が示したデータ基盤の条件
- 【基調講演】AIエージェントは「信頼」と「コスト」で選ばれる、Google Cloud・KDDI・MBKデジタルが示すデータ基盤の条件
- 【Track 1】AIエージェントは「初日の新入社員」 Google Cloud 山田氏が説く、データを動かさない「SOAP」アーキテクチャとコンテキスト運用
- 【Track 1】キリンビール営業部門、商談の質問に AI でその場で回答 BigQuery と Looker で約12週間で本番へ
- 【Track 1】三菱ケミカルが M365・AWS・ServiceNow を Google Cloud でつなぎ、ヘルプデスクを自律化
- 【Track 1】Google Cloud が示すエージェントのデータ基盤、BigQuery と Knowledge Catalog の役割
- 【Track 2】メルカリが dbt platform へ移行、AI エージェントでデータ基盤の運用を自律化
- 【Track 2】LegalOn Technologies、Agent Skill で現場にデータ基盤を渡し「構造」で守る運用
- 【Track 3】Google Cloud が解説、BigQuery と Iceberg の使い分け 4つのテーブル形式と3つの連携パターン
- 【Track 3】ダイニーが AI エージェントを社内向けと社外向けで設計し分ける理由、誤答の影響で「LLM に任せる範囲」を決める
- 【Track 3】Google Cloud が語る「見る BI」の先 Looker で AI と会話し、作らせ、エージェントから使う
- 【Track 3】Google Cloud が提言、AI エージェントから本番 DB を守る「サービング DB」と3つの設計要件
- 【Track 3】MIXI が Looker の会話分析をサブエージェントに、アナリストが自ら育てる「モンスト」の社内分析 AI
本イベントのほかのレポートも公開しています
この記事では Track 2 の G-gen のセッションを取り上げました。ほかの12本のレポートは、上の一覧からご覧いただけます。(trends. 編集部)















What's New
新着記事

Googleが社内のデータシミュレーターの仕組みを紹介、短い説明から架空企業のデータと検証済みの正解の生成が可能

アストリス・アドバイザリー・ジャパン株式会社が株式 会社ジェイテックコーポレーション(証券コード:3446)に関する2027年3月期1Q決算アップデートレポートを発行

1月13日(水) AndTech「広視野・高精細化・小型軽量化を実現するXR・AR用ヘッドマウン トディスプレイの光学設計とレーザ網膜投影技術」Zoomセミナーを開講予定

1月13日(水) AndTech「光電融合・CPO向け光コネクタ・光導波路の開発と周辺材料への 要求特性・信頼性評価」Zoomセミナーを開講予定

