


Google Cloud が解説、BigQuery と Iceberg の使い分け 4つのテーブル形式と3つの連携パターン
公開:
Apache Iceberg でテーブルの形式はそろえられても、カタログ、クラウド、権限の分断は残る。Google Cloud は、BigQuery を中心に置いた「Lakehouse」でその境界をつなごうとしている。
Google Cloud の「Data & AI Summit '26 Fall」で、Google Cloud の堤 崇行氏が、BigQuery と Iceberg を組み合わせたアーキテクチャの設計を解説した。BigQuery で扱える4つのテーブル形式の違い、AWS や Azure にあるデータを参照する2つの方式、そして要件から選ぶ3つの連携パターンを、Databricks のデータを BigQuery から分析するデモとあわせて紹介した。
この記事の要点
- Iceberg の採用が広がるにつれ、カタログとエンジン、クラウド間の複製、ガバナンスの3つの分断が課題になる。Google Cloud は旧 BigLake の「Lakehouse」で、単一のメタデータ層からこれらをつなぐ
- BigQuery で扱うテーブルは、ネイティブ、BigQuery 管理の Iceberg、Lakehouse 管理の Iceberg、外部カタログ連携の4種類。他クラウドのデータは、Iceberg なら Federated Catalog、カタログのないファイルなら Cross-Cloud Connections で参照する
- デモでは、Databricks の Unity Catalog にあるテーブルを BigQuery から参照し、BigQuery のテーブルと1本の SQL で結合したうえで、会話分析で自然言語の質問に答えさせた
目次
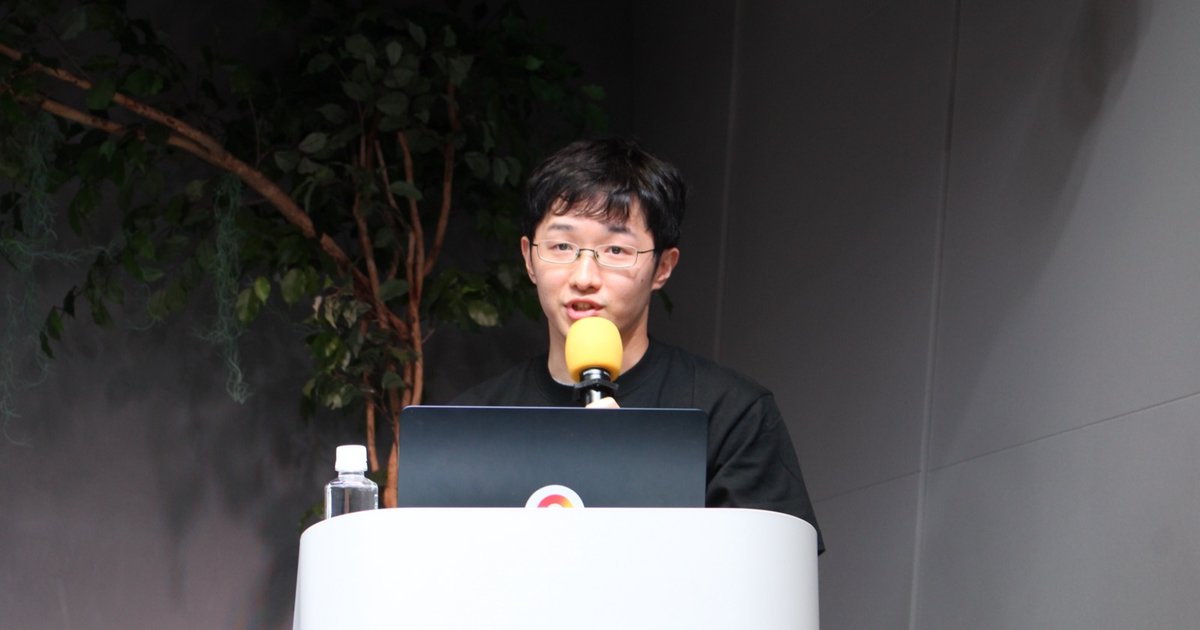
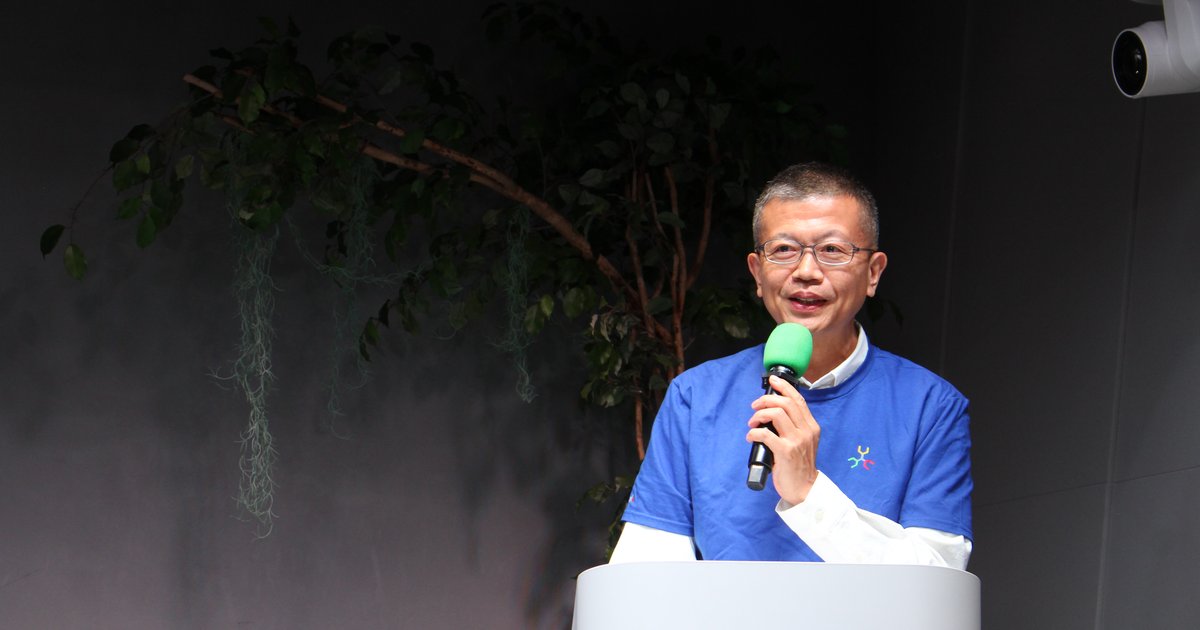
Google Cloud は2026年11月18日、データと AI をテーマにしたイベント「Data & AI Summit '26 Fall」を Google 渋谷オフィスとオンラインで開いた。Track 3 のブレイクアウトセッション「BigQuery と Iceberg のアーキテクチャ設計 ― マルチクラウド対応と連携パターン」には、Google Cloud データ アナリティクス スペシャリスト テックリードの堤 崇行氏が登壇した。堤氏は冒頭、会場に Iceberg の利用状況を挙手で尋ねた。すでに導入している人はまだ多くない様子で、堤氏は、さまざまな DWH が Iceberg 対応をうたう中、Google Cloud もきちんと対応していることを示したいと話した。

Google Cloud データ アナリティクス スペシャリスト テックリードの堤 崇行氏
Iceberg の普及で生まれる「新たなサイロ」
グループ会社や複数のサービスを持つ企業がデータを連携しようとすると、どの形式でそろえるかが問題になる。堤氏によると、そこで魅力的に映るのがオープンテーブルフォーマットであり、その中では Apache Iceberg がほぼデファクトになりつつある。
ただし、Iceberg を選んでテーブルの形式をそろえても、別の分断が残る。スライドでは、これを「オープン化の裏で生じる新たなデータ サイロ」として3つに整理していた。
① カタログとエンジンの分断
BigQuery は独自のカタログ、Spark などの OSS は別のメタストアを持つ。エンジンごとにカタログを管理することになり、書き込みの競合やスキーマの同期も負担になる。
② クラウド間の複製と転送負荷
他のクラウドの S3 などにあるデータを使うたびに ETL を作り、コピーを二重に持つ。ストレージの二重課金と転送料が発生する。
③ ガバナンスと運用の二重化
バケット全体に IAM 権限を付けると、広すぎる権限を配るリスクがある。小さなファイルの統合(Compaction)やガベージコレクションのジョブも手で運用することになる。
※スライド「オープン化の裏で生じる新たなデータ サイロ」をもとに編集部が整理
堤氏が示した解決の方向性は、単一のオープンなメタデータ層を持ち、「エンジンの境界」と「クラウドの境界」を透過的につなぐことだ。

Iceberg の採用が広がるにつれ、カタログ・クラウド・権限の分断が表面化する
その中核になるのが、Google Cloud の「Lakehouse」だ。スライドには「旧 BigLake から進化し マルチエンジンとマルチクラウドを単一カタログ層で統合」とあり、BigLake は2026年4月に Lakehouse へ、BigLake metastore は Lakehouse runtime catalog へと名前が変わっている[1]。Cloud Storage 上の Iceberg テーブルに加え、AWS Glue Data Catalog、Databricks Unity Catalog、Snowflake Horizon Catalog などで管理されている他クラウドのテーブルも、Lakehouse を通せば BigQuery や Managed Service for Apache Spark、Gemini、Looker から使える。堤氏によると、Lakehouse の管理下に入れたデータは Knowledge Catalog によるメタデータやコンテキストの管理の対象にもなり、AI からも参照しやすくなる。

Lakehouse runtime catalog と Knowledge Catalog が、ストレージと分析エンジン・AI の間に入る
他クラウドや SaaS のデータを、ガバナンスごとつなぐ
続いて堤氏は、2026年の Lakehouse 関連のアップデートを紹介した。最初に挙げたのが、AWS や Azure など他のクラウドと接続する機能(Borderless Lakehouse)だ。堤氏はこれが「今月 GA になった」と述べた。リリースノートでも、Databricks Unity Catalog、AWS Glue、Snowflake Horizon などを外部カタログとして連携する機能と、後述のインテリジェント キャッシングが、2026年11月2日に一般提供(GA)になったことが確認できる[1]。
堤氏は、これまで BigQuery は他のクラウドにあるデータの参照が弱いと言われがちだったと認めたうえで、クラウドをまたいだ分析を支える仕組みとして2つを挙げた。1つは、クラウド同士を専用線で直接つなぐ「Cross-Cloud Interconnect」だ。インターネット経由は社内ルール上使えない、速度を安定させたい、といった場合に使え、データ量が多ければ転送料も安くなる。もう1つが「インテリジェント キャッシング」で、使った部分だけをブロック単位でキャッシュし、クラウドをまたぐ通信の量そのものを減らす。スライドでは、エージェントに多い繰り返し・定型的なクエリのコストを削減できると説明していた。
つなげる先はクラウドのデータレイクだけではない。スライドには、Oracle や PostgreSQL などのデータベース、SAP、Salesforce、ServiceNow、Workday といった SaaS、Databricks と Snowflake が並び、S3 互換のオンプレミスのストレージは「Roadmap」とされていた。堤氏は SAP などの例を挙げ、API を解読して ETL を作らなくても参照できるようになっていると説明した。
ガバナンスとセキュリティのアップデートも紹介した。スライドでは、次の4つの提供状況が示されていた。
| 領域 | 機能 | 提供状況 |
|---|---|---|
| カタログ | 認証情報の払い出し(クレデンシャル ベンディング)。ソース側のカタログが引き続き正本 | GA |
| アイデンティティ | アイデンティティ伝播。各クエリをログイン中のユーザーとして実行 | GA |
| アクセス | きめ細かいアクセス制御。クロスクラウドのテーブルに列マスクと行フィルタ | Roadmap |
| ネットワーク | Cross-Cloud Interconnect によるプライベート接続とネットワーク分離 | GA |
※スライド「ひとつのアイデンティティとガバナンス モデル」をもとに編集部が整理
クレデンシャル ベンディングについて堤氏は、テーブルにアクセスできる人だけが、その裏のバケットやオブジェクトにアクセスできる認証情報を、固定のキーではなく都度払い出す仕組みだと説明した。オブジェクトストレージの権限を別に配らずに済み、権限管理も一元化できる。アイデンティティ伝播は、Databricks や Snowflake を併用している企業で「権限管理をどちらに寄せるか」という課題に応えるものだ。Databricks Unity Catalog のユーザー ID 連携は、2026年11月2日に GA になっている[2]。

カタログ、アイデンティティ、ネットワークは GA、列マスクと行フィルタはロードマップ
AI との組み合わせとして示されたのが「Gemini × Borderless Lakehouse」だ。たとえば「今月の EC 売上の合計は?」と尋ねると、どのデータを見て、どう結合すればよいかを Knowledge Catalog が教え、その情報をもとに作ったクエリが Borderless Lakehouse を通じて、他のクラウドや SaaS のデータにも届く。スライドによれば、結合はゼロコピーのフェデレーションでソース側で実行し、簡潔な結果だけをエージェントに返す。堤氏は、BigQuery にはデータエージェントを簡単に作る仕組みがあり、Databricks にあるデータも含めて「3クリックぐらいで」作れると述べた。

質問の意味は Knowledge Catalog が補い、データの所在の違いは Borderless Lakehouse が吸収する
BigQuery 管理の Iceberg テーブルを使う利点
堤氏は、BigQuery が管理する Iceberg テーブルならではの利点も紹介した。1つはマルチステートメント トランザクションだ。複数のテーブルにまたがる更新を1つの単位として扱い、コミットするまではロールバックできる。Iceberg そのままでは単一のクエリ単位などの制約があるが、BigQuery 管理の Iceberg テーブルでは、通常のデータベースのような ACID 特性を持ったトランザクションを組める。スライドでは、財務データの更新や、GDPR/CCPA に基づく削除要求の確実な実行といった用途が挙げられていた。
もう1つは、CDC(変更データキャプチャ)によるリアルタイムな取り込みだ。堤氏によると、Iceberg は他のオープンテーブルフォーマットに比べて、リアルタイムにデータを入れると管理が大変になり、不要なファイルも増えやすい。BigQuery が間に入って一旦受け止めることでこれを解決し、業務データベースやログをリアルタイムに連携できるという。
このほか、Lakehouse runtime catalog で管理する Iceberg テーブルに BigQuery から DML を実行する機能がプレビューで出ていること[1]、BigQuery や Lakehouse のデータを分析した結果を Spanner、Bigtable、AlloyDB に書き戻す「リバース ETL」の機能を順次提供していることも紹介した。分析結果をアプリケーションのバックエンドに戻し、フロントエンドから使いやすくするための仕組みだ。
BigQuery で扱う4つのテーブル形式
セッションの中心は、テーブル形式の選び方だった。スライドでは、ストレージの所在とカタログの管理主体によって、BigQuery で扱うテーブルを4つに分けていた。

4つの選択肢は、エンジン、カタログの管理主体、物理ストレージの3つの観点で違う
| 形式 | 主なエンジン・利用 | カタログ | 物理ストレージ | 位置づけ |
|---|---|---|---|---|
| ① BigQuery ネイティブ | BigQuery の全機能 | BigQuery カタログ | BigQuery 管理ストレージ | 高速な BI・AI 分析の第一選択 |
| ② BigQuery 管理 Iceberg | BigQuery が書き込み・更新、OSS エンジンは読み取り | BigQuery カタログ | 自社の Cloud Storage | BigQuery 主導で管理しつつオープンに公開 |
| ③ Lakehouse 管理 Iceberg | OSS と BigQuery が双方向に読み書き(BigQuery の DML はプレビュー) | Lakehouse runtime catalog | 自社の Cloud Storage | マルチエンジン共存の中核 |
| ④ 外部カタログ連携 | BigQuery・Managed Spark から読み取り | 外部カタログを自動同期 | Amazon S3/ADLS/GCS | マルチクラウドのデータをその場で分析 |
※スライド「BigQuery で扱う 4 つのテーブル アーキテクチャ」をもとに編集部が整理
堤氏の整理はこうだ。一番速くて安いのはネイティブテーブル。公開して他のエンジンにも読ませたいなら BigQuery 管理の Iceberg。BigQuery からも読み書きはするが、Spark など OSS を主体にするなら Lakehouse 管理の Iceberg。他のクラウドにあるものをそのまま参照したいなら外部カタログ連携、というイメージになる。
迷いやすいのが、②と③の2つのマネージド Iceberg テーブルの違いだ。BigQuery 管理の Iceberg テーブルは、列・行レベルのセキュリティやデータマスキングを BigQuery のネイティブテーブルのように使え、Storage Write API による高スループットなストリーミングにも対応する。その代わり、Spark などの OSS エンジンから直接書き込むことはできない。一方、Lakehouse runtime catalog 管理の Iceberg テーブルは、OSS エンジンと BigQuery の双方から書き込める。標準の Iceberg REST カタログなので、オープンにしたいという要望に合うことが多いが、スライドによれば BigQuery の行・列レベルのセキュリティには現時点で対応していない。堤氏は、性能面でも今は BigQuery 管理のほうが優れているとしつつ、ロードマップでアップデートが多そうな部分だと述べた。
では、どれか1つに統一すべきか。堤氏は「統一したい気持ちはすごく出てくるが、このご時世、データウェアハウスのレベルでも統一は難しい」と話し、データの階層とワークロードに応じて使い分けることを勧めた。ブロンズやシルバーの層ではそれぞれの形式で整えつつ、特に AI から使うゴールドの層では BigQuery を選ぶ顧客も多いという。堤氏は、BigQuery のオートスケールが今年特に改善し、AI のように断続的に大量のクエリが来る用途に効果があると話した。ゴールドの層のデータを他のチームに渡す場合は、BigQuery から書き込める Iceberg を用意すれば、エクスポートして使い終わったら消す、といった手間がなくなるという。
オープンにするほど BigQuery の機能からは離れる。すべてを Iceberg にそろえるのではなく、速さが要る層は BigQuery ネイティブ、他のエンジンと共有する層は Iceberg と、データの役割ごとに選ぶ。
他クラウドのデータを参照する2つの方式
AWS や Azure にあるデータを BigQuery から使う方法は2つある。1つは、外部の Iceberg カタログを同期する「Lakehouse Federated Catalog」(GA)。もう1つは、BigQuery の外部テーブルを他のクラウドに対しても作れる「BigQuery Cross-Cloud Connections」で、スライドでは Preview と表記されていた[2]。堤氏は、Iceberg をまだ使っていない企業も多いことから、Iceberg 以外のファイルを BigQuery から参照できるようにしたのが Cross-Cloud Connections だと説明した。

カタログがあれば Federated Catalog、カタログのないファイルなら Cross-Cloud Connections
| 比較の観点 | Federated Catalog(GA) | Cross-Cloud Connections(Preview) |
|---|---|---|
| 対象データ | 外部の Iceberg カタログ(Glue/Unity/Horizon など) | S3・Azure Blob 上のファイル(Parquet・CSV など) |
| メタデータ | カタログ単位で自動同期(最短300秒) | 外部テーブル・外部スキーマを個別に定義 |
| 利用エンジン | BigQuery・Managed Spark・Apache Spark | BigQuery のみ |
| 向いている場面 | Iceberg カタログの横断、Spark との併用 | カタログのないファイルを BigQuery で分析 |
※スライド「マルチクラウド接続方式の判断軸」をもとに編集部が整理
堤氏は、Iceberg であれば Federated Catalog を使うのが基本だと話した。テーブルが増えたり、スキーマが変わったりしても自動で更新され、Iceberg 自体が必要なデータだけを取ってくる仕組みを持つため、たいていの場合は性能面でも有利だという。一方、少しだけデータを連携したい、とりあえず参照して別のデータマートを作りたい、Iceberg 形式ではない、といった場合は、Cross-Cloud Connections で BigQuery から直接参照できる。
3つの連携パターンと、Databricks × BigQuery のデモ
最後のパートで堤氏は、典型的な構成を3つのパターンとして示した。
パターン A:Google Cloud 内のマルチエンジン共存
Lakehouse runtime catalog で Iceberg テーブルを管理し、Spark、Dataflow、BigQuery から双方向に読み書きする。オープンソースにこだわる構成。コンパクションなどの管理ジョブを自動で任せられる(自動テーブル管理はスライドでは Preview)。
パターン B:マルチクラウド・外部カタログ統合
AWS Glue、Databricks Unity Catalog、Snowflake Horizon Catalog にある Iceberg を Federated Catalog で参照し、Google Cloud 上のデータマートとゼロコピーで結合する。参照専用。Iceberg 以外のファイルは Cross-Cloud Connections でつなぐ。
パターン C:BigQuery 管理データの安全な外部公開
BigQuery でストリーミング取り込みや自動最適化を行い、BigQuery 管理の Iceberg テーブルとして Spark、Trino、Flink などの外部エンジンに読み取り専用で公開する。BigQuery から CTAS するだけで Iceberg テーブルができる。
※スライド「パターン A」「パターン B」「パターン C」をもとに編集部が整理

パターン B は、他クラウドの Iceberg 資産と Google Cloud 上のデータマートをコピーせずに結合する
パターン B の構成例として、東京リージョンどうしで AWS Glue のカタログと BigQuery を連携する設定も紹介された。スライドによれば、静的なアクセスキーを使わず OIDC の短命トークンで信頼関係を結び、gcloud コマンドでフェデレーテッド カタログを作成して同期を有効にすれば、BigQuery のテーブルと Glue 側のテーブルを1本の SQL で JOIN できる。
デモ:Databricks のテーブルを BigQuery から分析する
続いて、パターン B を実際に動かすデモ動画(約1分)が流された。動画は自動で再生されず、堤氏が操作しながらの紹介になった。始めるのに必要なのは3ステップだと堤氏は説明した。Databricks 側で、共有したい Delta Lake のテーブルの UniForm を有効にして Iceberg として読めるようにすること、Lakehouse に Databricks のカタログを指す Federated Catalog を作ること。そこまでできれば、あとはクエリを書くか、質問するだけだ。
デモは次の流れで進んだ。
- STEP 1:Databricks の Unity Catalog で、CRM の受注実績テーブル(Delta Lake、UniForm で Iceberg も有効)と、受注 ID・顧客セグメント・金額など7列のスキーマを確認する
- STEP 2:BigQuery Studio を開くと、連携したカタログとして Databricks のテーブルが表示される。スキーマや列の説明は Databricks と同じで、テーブルの詳細では、データの場所が Unity Catalog が管理する S3 上であること、カタログのソースが Databricks Unity(Iceberg REST カタログ経由)であることが分かる
- STEP 3:Databricks 側の受注テーブルと、BigQuery のネイティブテーブルにある広告キャンペーンの日次データを1本の SQL で JOIN し、キャンペーン別の広告費と受注売上(ROAS)を集計する
- STEP 4:この2つのテーブルをナレッジソースにしたデータエージェントに、会話分析で「3月26日に売上が落ち込んだ理由と、影響を受けた顧客セグメント」を自然言語で尋ねる。エージェントは両方のデータを組み合わせて答え、顧客セグメント別の売上推移のグラフも自動で作った
※デモ画面の表示と堤氏の説明をもとに編集部が整理。デモのデータは説明用に用意されたもの

STEP 1:Databricks で Delta Lake のテーブルを確認。UniForm で Iceberg のメタデータも自動で作られる

STEP 2:BigQuery Studio から同じテーブルを参照。ソースは Databricks Unity

STEP 3:Databricks と BigQuery のデータを JOIN し、キャンペーン別の ROAS を集計

STEP 4:会話分析で自然言語の質問に回答し、グラフも自動で作成
堤氏によると、この会話分析のエージェントは BigQuery の Conversational Analytics の機能で、「本当に3クリック、2クリックでも」作れる。その分析の対象に、他のクラウドにあるデータも入れられるようになったという。
要件から選ぶアーキテクチャ
締めくくりに堤氏は、ここまでの内容を選定フローにまとめた。最初の分かれ目は、対象のデータがどこにあるかだ。
- Google Cloud 内:BigQuery で完結し最速の BI・AI 分析をしたいなら BigQuery ネイティブテーブル。BigQuery で書き込みを管理しつつ外部に公開したいなら BigQuery 管理の Iceberg(パターン C)。Spark や Flink などと双方向に読み書きしたいなら Lakehouse 管理の Iceberg(パターン A)
- 他のクラウド(AWS/Azure など):外部の Iceberg カタログがあれば Federated Catalog(パターン B)。カタログのないファイルなら BigQuery Cross-Cloud Connections
※スライド「要件から選ぶアーキテクチャ選定フロー」をもとに編集部が整理

どのパターンを選んでも、Knowledge Catalog のガバナンスと Gemini/Conversational Analytics につながる
堤氏が最後に強調したのは、どのパターンを選んでも Knowledge Catalog の管理対象になり、Gemini などによる AI の分析、これまでの BI、会話分析やエージェントによる分析にまで対応できるという点だ。「BigQuery を真ん中に置いてもらえれば、他のクラウドのデータも、頑張って集めなくても使える」。それが Iceberg でデータをオープンにすることの効果の1つだと話し、セッションを締めくくった。

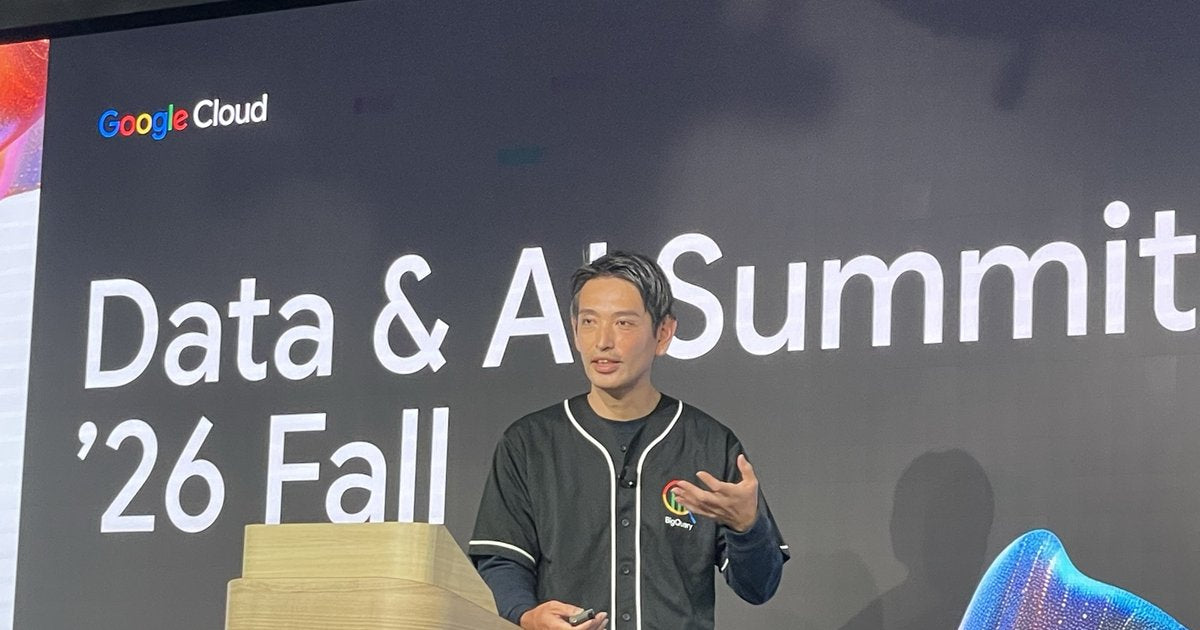
デモの後、パターン C と選定フローを説明する堤氏
登壇者
データ アナリティクス スペシャリスト テックリード
開催概要
| イベント | Data & AI Summit '26 Fall(主催:Google Cloud) |
|---|---|
| 開催日 | 2026年11月18日(水) |
| 会場 | Google 渋谷オフィス+オンライン配信 |
| セッション | 【Track 3】BigQuery と Iceberg のアーキテクチャ設計 ― マルチクラウド対応と連携パターン |
| 登壇 | 堤 崇行氏(Google Cloud データ アナリティクス スペシャリスト テックリード) |
出典:Data & AI Summit '26 Fall 公式ページ
References
- Google Cloud「Lakehouse release notes」. https://docs.cloud.google.com/lakehouse/docs/release-notes(参照 2026-11-19)
- Google Cloud「BigQuery release notes」. https://docs.cloud.google.com/bigquery/docs/release-notes(参照 2026-11-19)
Data & AI Summit '26 Fall のほかのレポート
- 【総括】AI エージェントに任せる前に、データに「意味」を Google Cloud と登壇10社が示したデータ基盤の条件
- 【基調講演】AIエージェントは「信頼」と「コスト」で選ばれる、Google Cloud・KDDI・MBKデジタルが示すデータ基盤の条件
- 【Track 1】AIエージェントは「初日の新入社員」 Google Cloud 山田氏が説く、データを動かさない「SOAP」アーキテクチャとコンテキスト運用
- 【Track 1】キリンビール営業部門、商談の質問に AI でその場で回答 BigQuery と Looker で約12週間で本番へ
- 【Track 1】三菱ケミカルが M365・AWS・ServiceNow を Google Cloud でつなぎ、ヘルプデスクを自律化
- 【Track 1】Google Cloud が示すエージェントのデータ基盤、BigQuery と Knowledge Catalog の役割
- 【Track 2】メルカリが dbt platform へ移行、AI エージェントでデータ基盤の運用を自律化
- 【Track 2】G-gen が検証、BigQuery に表と列の説明と業務用語を書くと AI の正答率は17%から100%に
- 【Track 2】LegalOn Technologies、Agent Skill で現場にデータ基盤を渡し「構造」で守る運用
- 【Track 3】ダイニーが AI エージェントを社内向けと社外向けで設計し分ける理由、誤答の影響で「LLM に任せる範囲」を決める
- 【Track 3】Google Cloud が語る「見る BI」の先 Looker で AI と会話し、作らせ、エージェントから使う
- 【Track 3】Google Cloud が提言、AI エージェントから本番 DB を守る「サービング DB」と3つの設計要件
- 【Track 3】MIXI が Looker の会話分析をサブエージェントに、アナリストが自ら育てる「モンスト」の社内分析 AI
本イベントのほかのレポートも公開しています
この記事では Track 3 の Google Cloud による BigQuery と Iceberg のセッションを取り上げました。ほかの12本のレポートは、上の一覧からご覧いただけます。(trends. 編集部)















What's New
新着記事

Googleが社内のデータシミュレーターの仕組みを紹介、短い説明から架空企業のデータと検証済みの正解の生成が可能

アストリス・アドバイザリー・ジャパン株式会社が株式 会社ジェイテックコーポレーション(証券コード:3446)に関する2027年3月期1Q決算アップデートレポートを発行

1月13日(水) AndTech「広視野・高精細化・小型軽量化を実現するXR・AR用ヘッドマウン トディスプレイの光学設計とレーザ網膜投影技術」Zoomセミナーを開講予定

1月13日(水) AndTech「光電融合・CPO向け光コネクタ・光導波路の開発と周辺材料への 要求特性・信頼性評価」Zoomセミナーを開講予定

